前端面试
前端面试知识体系:CSS、渲染与性能、JS 运行机制、原型链、TypeScript、Virtual DOM、框架与元框架、HTTP、安全、Node.js、工程化、a11y 与 AI 前端等专题,附高频手写题与易错点速查,按 2026 年现状修订。
一、前言
1.1 写在前面
做一个总结,总结自己的知识体系。
话不多说,上车🚌
这篇最早写于 2021 年。这次修订保留了原来的结构和答题思路,主要做了三件事:修正写错或已经过时的结论(IE 时代的兼容写法、被废弃的 API、HTTP 缓存和 Node 事件循环的旧行为等);在相关小节里补充现在的推荐做法;把原来只有标题的面试题补上了答案要点。代码片段里的输出结果都用 Node 24 / 现代浏览器重新跑过。
1.2 指南
mindmap
  root((面试指南))
    简历
      自我介绍
      工作描述
        任职时长、岗位
        工作内容
        业绩:用数据表明
    投递方式
      内推
      分批投递
        Boss
        拉勾
    公司是否靠谱
      天眼查
      人脉
    面试题
      笔试
      项目
    问答
      技术
        自我介绍
        项目经验
        职业规划
      团队管理
      软技能
    薪酬
      money 💰
        预要
        实际
      薪资构成
        基本工资
        绩效
        期权
    选择 Offer
      社保:缴纳基数
      公积金:缴纳基数
      试用期:不低于转正工资的 80%
      考核/晋升
        晋升空间
        发展平台
        薪资/调薪
          次数
          标准
      年终奖:写进合同
1.3 面试考察
考察基础知识与知识广度
面试技巧
mindmap
  root((面试技巧))
    沟通技巧
      沟通原则:客观描述事实,不做主观臆断
      三说:知道的知识自信说,模糊的知识假设说,陌生的知识诚实说
      三不说:不说谎话,不说抱怨的话,不说轻浮的话
    面试节奏
      引导对方:由知识点 A 引出知识点 B、C,预埋问题坑位,引导对方提问
      渲染情绪:感知对方情绪,判断策略,引发对方共情
      反问阶段:了解对方团队、技术栈、痛点问题、组织定位……
各轮面试考察什么
mindmap
  root((面试考察))
    技术一面:基础和知识广度,专业 80% + 软素质 20%
      计算机基础:算法、数据结构
      前端基础:JS/CSS、前端框架、Node、浏览器原理、网络、安全、跨端能力
      编码能力:逻辑是否清晰、边界是否考虑到、思维是否活跃
      技术视野:行业技术现状、新技术的了解和实践
    技术二面:工程、设计、规划能力,专业 60% + 软素质 40%
      工程能力:效率、质量、性能、定义标准、产出规范
      设计能力:抽象能力、拆解能力、健壮性、扩展性
      规划能力:做事的思路是什么
      沟通和推动能力:是否有一套自己的项目推动方法和成功 case
      产品意识:目标是什么?存在哪些问题?如何解决?价值体现在哪里?
      其他软实力:聪明程度、学习能力、责任心、价值观
    技术三面
      技术格局与视野
      人生规划
      软技能考察
描述项目:STAR 法则
STAR 即情境 Situation、任务 Task、行动 Action、结果 Result,展开来可以按下面 8 个点准备:
mindmap
  root((描述项目))
    背景:项目背景,是在什么情况下发生的
    角色:我当时承担了什么角色
    职责:负责工作的哪一方面,协调、开发……
    难题:遇到了什么难题,怎么解决的,为什么这么解决
    结果:项目结果如何,有数据支撑更有说服力
    沉淀:做完这个项目沉淀了什么,给别人带来什么
    复盘:如果重新让你做这件事,你会怎么做,有什么更好的方案
    评价:项目中的表现,周围的小伙伴怎么评价,上级怎么评价
1.4 思考
1.4.1 年底与年初哪个属于跳槽的最佳时期?
入职前...
拿到offer时,你最好就开始思考预测未来3-5年,你的工作与生活,该怎么走
1.5 参考
1.5.1 学习
- 背景:学的很累
- 原则:先少后多、先精后广
- 方法:平衡学习、工作、生活时间与利用社区的力量
1.5.2 成长
- 定义:技术、做事
- 方法:自驱动、敢于挑战、承担责任
- 自测:技术架构、独立做事、彼此成就
1.5.3 晋升
- 目标:加薪、晋升
- 方法:少说、多做、任劳任怨、有效的沟通、拒绝平庸、全面发展
- 心态:先付出在回报、个人服从集体、学会定位和补位、足够耐心
1.6 总结
面试题更多时候是一个引子,更多是想通过面试题去思考题目背后带来的对某一模块的深入学习和探讨。
二、CSS
2.1 CSS 盒模型
2.1.1 基本概念
2.1.1.1 标准模型
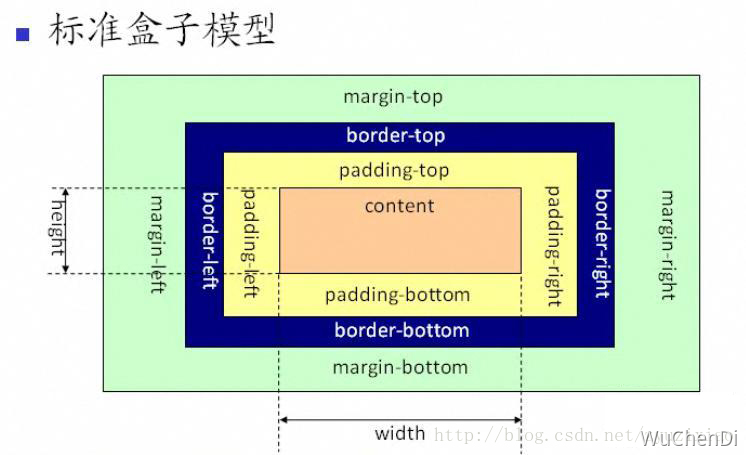 从上图可以看到标准 W3C 盒子模型的范围包括 margin、border、padding、content,并且 content 部分不包含其他部分。
2.1.1.2 IE 模型
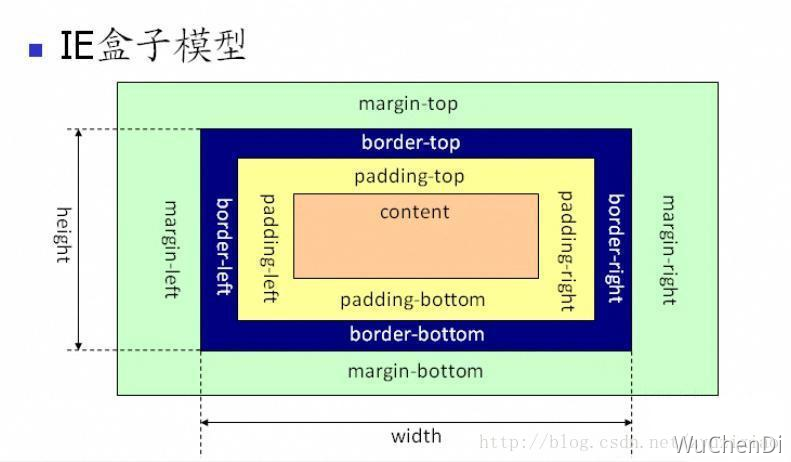 从上图可以看到 IE 盒子模型的范围也包括 margin、border、padding、content,和标准 W3C 盒子模型不同的是:IE 盒子模型的
width / height 包含了 border 和 padding。
2.1.2 CSS 如何设置这两种模型
/* 标准模型 */
box-sizing: content-box;
/* IE 盒模型 */
box-sizing: border-box;

/* 浏览器默认值:box-sizing: content-box */
现在几乎所有项目都会在 reset 里全局设 *, *::before, *::after { box-sizing: border-box; }(Tailwind 的 Preflight 也是这么做的),因为「写多宽就是多宽」更符合直觉。面试时说清两种模型的区别、以及为什么大家默认用 border-box 就够了。
2.1.3 JS 如何设置获取盒子模型对应的宽和高
dom.style.width / height // 只能取到内联样式

dom.currentStyle.width / height // 仅旧版 IE,已无意义

window.getComputedStyle(dom).width / height // 计算后的样式

dom.getBoundingClientRect().width / height // 实际渲染尺寸(含 transform 缩放)offsetWidth(含 border)、clientWidth(不含 border 和滚动条)也常被问到;需要监听尺寸变化时用 ResizeObserver,不要轮询。
2.1.4 实例题(根据盒模型解释边距重叠)
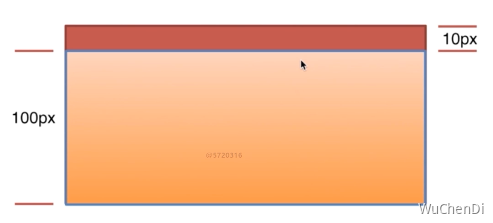 如上图:有两个元素其中子元素高度为 100px,子元素与父元素的上边距为 10px,求父元素的实际高度?
答案: 说 100px 对,说 110 也对,为什么捏?这个要看父元素有没有创建 BFC
<style>
  html,
  * {
    padding: 0;
    margin: 0;
  }
  #sec {
    background: #f00;
  }
  .child {
    height: 100px;
    margin-top: 10px;
    background: yellow;
  }
</style>
<body>
  <section id="sec">
    <article class="child"></article>
  </section>
</body>
运行效果:
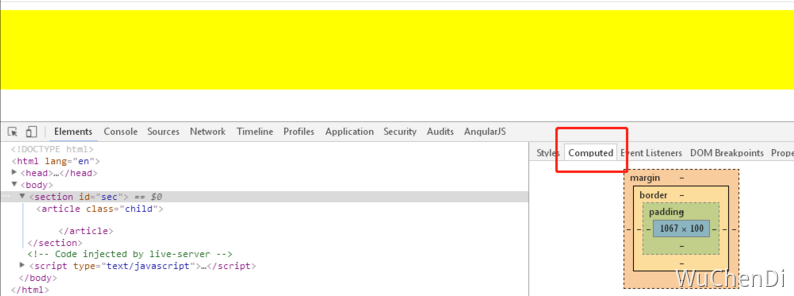 上图证明 100px 是对的
元素加个 overflow:hidden
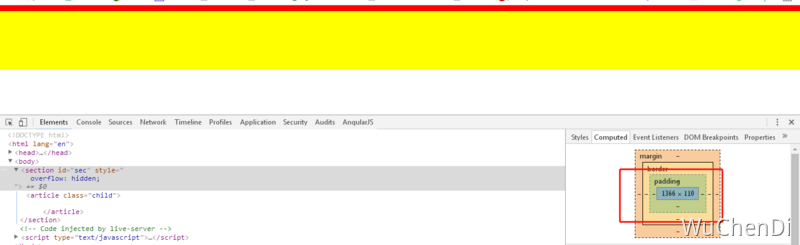 你会发现这时高度为 110px, 这时大家可能会疑问,为什么给父级元素设置一个 overflow:hidden 以后,它的高度就成 110 呢,这块的基本原理是啥呢,咋就这样呢?说这个之前,先引用一个知识点:
上面代码是父子元素边距重叠,那么还有两种情况边距重叠就是,一种是兄弟元素,就是两个 div 挨着,每个都上边距或者下边距,那么重叠的原则就是取最大值。
来回答上面问题:给父级加了 overflow:hidden,其实就是给父级元素创建一个 BFC(块级格式化上下文)。
2.2 BFC
2.2.1 基本概念
Block Formatting Context, 块级格式化上下文,一个独立的块级渲染区域,该区域拥有一套渲染规格来约束块级盒子的布局,且与区域外部无关。
2.2.2 BFC 的原理
- 同一个 BFC 内相邻块级盒子的垂直外边距会发生重叠
- BFC 的区域不会与浮动元素的 float 重叠
- 独立的容器,内外元素互不影响
- 计算 BFC 高度,浮动元素也参与计算
2.2.3 如何创建 BFC
- 根元素
<html> - float 不为 none 的时候
- position 为 absolute 或 fixed 的时候
- display 为 inline-block、table-cell、table-caption 等表格相关值的时候
- display 为
flow-root的时候(专门用来创建 BFC,没有副作用) - overflow 不为 visible 和 clip 的时候(auto、hidden、scroll)
- flex / grid 容器的直接子项(它们创建的是 flex/grid 格式化上下文,表现类似)
contain: layout | content | paint的时候
以前清浮动、防 margin 重叠习惯写 overflow: hidden,副作用是会裁掉溢出内容(比如阴影、下拉菜单)。现在直接用 display: flow-root,所有现代浏览器都支持。另外布局基本都交给 flex / grid 之后,float 只剩「文字环绕图片」这个本职用途,BFC 在实际开发里出现得少了,但依然是面试常考点。
2.2.4 BFC 使用场景
- BFC 垂直方向边距重叠
<section id="margin">
  <style>
    #margin {
      background: pink;
      overflow: hidden;
    }
    #margin > p {
      margin: 5px auto 25px;
      background: red;
    }
  </style>
  <p>1</p>
  <div style="overflow:hidden">
    <p>2</p>
  </div>
  <p>3</p>
</section>- BFC 不与 float 重叠
<section id="layout">
  <style media="screen">
    #layout {
      background: red;
    }
    #layout .left {
      float: left;
      width: 100px;
      height: 100px;
      background: pink;
    }
    #layout .right {
      height: 110px;
      background: #ccc;
      overflow: auto;
    }
  </style>
  <div class="left"></div>
  <div class="right"></div>
</section>- BFC 子元素即使是 float 也会参与计算
<section id="float">
  <style media="screen">
    #float {
      background: red;
      overflow: auto;
      /*float: left;*/
    }
    #float .float {
      float: left;
      font-size: 30px;
    }
  </style>
  <div class="float">我是浮动元素</div>
</section>
2.3 link 标签和 import 标签的区别
- link 属于 html 标签,除了加载 CSS 还能做
preload、preconnect、icon等;@import是 CSS 提供的语法,只能导入样式。 - link 引用的 CSS 在解析 HTML 时就会被发现并并行下载;
@import要等外层 CSS 下载、解析后才会被发现,形成串行请求,拖慢首屏。 - link 可以通过 JS 操作 DOM 动态插入或修改,
@import不行。 - 两者引入的样式没有「权重高低」之分,冲突时按层叠规则(来源、优先级、出现顺序)决定。
现在 @import 主要出现在源码里,由构建工具(Vite、PostCSS、Lightning CSS 等)在打包时内联掉,不会真的发到浏览器。另外 @import url(...) layer(base); 可以直接把导入的样式放进某个 cascade layer。
2.4 选择器,优先级
id 选择器,class 选择器,标签选择器,属性选择器,伪元素选择器,伪类选择器等
优先级(specificity)按 (id 个数, class/属性/伪类 个数, 标签/伪元素 个数) 三元组逐位比较,不是简单相加:
- 同一元素引用了多个样式时,优先级相同则排在后面的样式生效;
- 样式选择器的类型不同时,优先级顺序为:内联样式 > id 选择器 > class 选择器 > 标签选择器;通配符
*和组合符(>、+、~、空格)不增加优先级; - 后代元素会继承祖先元素的部分样式(如 color、font),继承来的样式没有优先级,任何直接作用在元素上的规则(哪怕是
*)都会覆盖它; - 带有
!important标记的样式属性会盖过普通声明; <style>和<link>引入的样式本身没有高低之分,按出现顺序决定;- 样式表来源的顺序为:作者样式 > 用户样式 > 浏览器默认样式(
!important时反过来)。
现代 CSS 新增了几个管理优先级的工具,面试常会追问:
@layer:cascade layers,先比较层的顺序,再比较选择器优先级。后声明的层优先,未分层的样式优先于所有层。Tailwind v4 就是靠@layer theme, base, components, utilities管理覆盖关系。:where():优先级永远为 0,适合写容易被覆盖的默认样式。:is()/:not()/:has():优先级取参数里最高的那个。:has()就是期待多年的「父选择器」,2023 年底起主流浏览器都已支持。@scope:限定样式作用的 DOM 范围,同等优先级下离作用域根更近的规则胜出。
2.5 现代 CSS 新能力
这几年 CSS 新增的能力,很多以前要靠 JS 或第三方库实现:
2.5.1 容器查询 @container
媒体查询看的是视口宽度,容器查询看的是父容器的宽度,同一个组件放在侧边栏和主内容区会自动适配,这才是真正的「组件级响应式」:
.card-list {
  container-type: inline-size;
}

@container (min-width: 600px) {
  .card {
    display: grid;
    grid-template-columns: 200px 1fr;
  }
}
2.5.2 原生弹层:popover 与 dialog
<button popovertarget="menu">打开菜单</button>
<div id="menu" popover>点击外部或按 Esc 自动关闭</div>

<dialog id="confirm">
  <form method="dialog"><button>确定</button></form>
</dialog>
<!-- confirm.showModal() 打开模态框:自带遮罩、焦点锁定、Esc 关闭 -->两者都渲染在顶层(top layer),不受父元素 overflow: hidden 和 z-index 的影响,以前写弹窗要处理的层级、焦点、点击外部关闭等问题,浏览器都处理好了。
2.5.3 锚点定位 Anchor Positioning
让一个元素相对另一个元素定位(tooltip、下拉菜单),空间不够时还能自动翻转,以前要靠 Popper / Floating UI 计算:
.trigger {
  anchor-name: --trigger;
}
.tooltip {
  position: absolute;
  position-anchor: --trigger;
  position-area: top; /* 放在锚点上方 */
  position-try-fallbacks: flip-block; /* 上方放不下就翻到下方 */
}
Chromium 和 Safari 26 已经支持,生产环境要注意兼容性,可以用 Floating UI 兜底。
2.5.4 View Transitions
页面状态切换时,浏览器自动给前后两个画面做过渡动画:
// 同一页面内:把 DOM 更新包在 startViewTransition 里
document.startViewTransition(() => updateTheDOM())
/* 跨文档(多页应用)的页面跳转也能有过渡,两个页面都要声明 */
@view-transition {
navigation: auto;
}
/* 给元素起同一个名字,前后两个页面里的它会平滑变形过去 */
.hero {
view-transition-name: hero;
}2.5.5 滚动驱动动画
动画进度跟着滚动位置走,阅读进度条、视差、元素进场效果都不用再监听 scroll 事件,而且动画跑在合成线程上,不占主线程:
.progress {
  animation: grow linear;
  animation-timeline: scroll(); /* 跟随最近的滚动容器 */
}
@keyframes grow {
  from { transform: scaleX(0); }
  to { transform: scaleX(1); }
}
2.5.6 颜色和其他
color-mix(in oklch, var(--brand) 80%, white):按比例混合颜色,主题色的浅色、深色变体不再需要预处理器。- 相对颜色语法:
oklch(from var(--brand) calc(l + 0.1) c h),基于已有颜色调整亮度、饱和度。 oklch():感知均匀的色彩空间,调亮度时色相不会跑偏,也能表示广色域颜色。- 原生嵌套:
.card { & .title { ... } },大部分场景不再需要 Sass。 :has()、@layer、@scope见上文的 选择器,优先级。
2.5.7 布局方式怎么选
- 一维排列(导航栏、按钮组、表单行)用 flex;
- 二维结构(页面骨架、卡片网格)用 grid,子元素要和父网格对齐时用
subgrid; - 组件要根据所在容器适配时用
@container,根据视口适配时才用媒体查询; - float 只用来做文字环绕图片,absolute 只用于弹层、角标这类脱离文档流的元素。
三、页面布局
3.1 三栏布局
题目:左右两栏固定 300px,中间自适应。生产环境的默认答案是 grid 或 flex:
/* grid:二维布局,一行声明三列 */
.layout {
  display: grid;
  grid-template-columns: 300px 1fr 300px;
}

/* flex:一维布局,中间 flex: 1 占满剩余空间 */
.layout {
  display: flex;
}
.layout .left,
.layout .right {
  width: 300px;
}
.layout .center {
  flex: 1;
  min-width: 0; /* 防止长内容撑破布局 */
}
面试时常会追问「还有哪些方法、各有什么问题」,五种方案对比如下:
| 方案 | 问题 |
|---|---|
| grid | 无,二维布局首选,配合 minmax()、@container 容器查询做响应式 |
| flex | 无,一维布局首选 |
| 浮动 | 脱离文档流,需要清浮动;中间栏 DOM 必须写在最后 |
| 绝对定位 | 脱离文档流,父容器高度撑不开 |
| 表格布局 | 一个单元格变高,同行其他单元格一起变高;语义不对 |
<section class="layout grid">
  <style>
    .layout.grid .left-center-right {
      width: 100%;
      display: grid;
      grid-template-rows: 100px;
      grid-template-columns: 300px auto 300px;
    }
    .layout.grid .left-center-right > div {
    }
    .layout.grid .left {
      width: 300px;
      background: red;
    }
    .layout.grid .center {
      background: yellow;
    }
    .layout.grid .right {
      background: blue;
    }
  </style>
  <h1>三栏布局</h1>
  <article class="left-center-right">
    <div class="left"></div>
    <div class="center">
      <h2>网格布局解决方案</h2>
      1.这是三栏布局的浮动解决方案; 2.这是三栏布局的浮动解决方案;
      3.这是三栏布局的浮动解决方案; 4.这是三栏布局的浮动解决方案;
      5.这是三栏布局的浮动解决方案; 6.这是三栏布局的浮动解决方案;
    </div>
    <div class="right"></div>
  </article>
</section><section class="layout flexbox">
<style>
.layout.flexbox {
margin-top: 110px;
}
.layout.flexbox .left-center-right {
display: flex;
}
.layout.flexbox .left {
width: 300px;
background: red;
}
.layout.flexbox .center {
flex: 1;
background: yellow;
}
.layout.flexbox .right {
width: 300px;
background: blue;
}
</style>
<h1>三栏布局</h1>
<article class="left-center-right">
<div class="left"></div>
<div class="center">
<h2>flexbox解决方案</h2>
1.这是三栏布局的浮动解决方案; 2.这是三栏布局的浮动解决方案;
3.这是三栏布局的浮动解决方案; 4.这是三栏布局的浮动解决方案;
5.这是三栏布局的浮动解决方案; 6.这是三栏布局的浮动解决方案;
</div>
<div class="right"></div>
</article>
</section><section class="layout float">
<style media="screen">
.layout.float .left {
float: left;
width: 300px;
background: red;
}
.layout.float .center {
background: yellow;
}
.layout.float .right {
float: right;
width: 300px;
background: blue;
}
</style>
<h1>三栏布局</h1>
<article class="left-right-center">
<div class="left"></div>
<div class="right"></div>
<div class="center">
<h2>浮动解决方案</h2>
1.这是三栏布局的浮动解决方案; 2.这是三栏布局的浮动解决方案;
3.这是三栏布局的浮动解决方案; 4.这是三栏布局的浮动解决方案;
5.这是三栏布局的浮动解决方案; 6.这是三栏布局的浮动解决方案;
</div>
</article>
</section><section class="layout absolute">
<style>
.layout.absolute .left-center-right > div {
position: absolute;
}
.layout.absolute .left {
left: 0;
width: 300px;
background: red;
}
.layout.absolute .center {
left: 300px;
right: 300px;
background: yellow;
}
.layout.absolute .right {
right: 0;
width: 300px;
background: blue;
}
</style>
<h1>三栏布局</h1>
<article class="left-center-right">
<div class="left"></div>
<div class="center">
<h2>绝对定位解决方案</h2>
1.这是三栏布局的浮动解决方案; 2.这是三栏布局的浮动解决方案;
3.这是三栏布局的浮动解决方案; 4.这是三栏布局的浮动解决方案;
5.这是三栏布局的浮动解决方案; 6.这是三栏布局的浮动解决方案;
</div>
<div class="right"></div>
</article>
</section><section class="layout table">
<style>
.layout.table .left-center-right {
width: 100%;
height: 100px;
display: table;
}
.layout.table .left-center-right > div {
display: table-cell;
}
.layout.table .left {
width: 300px;
background: red;
}
.layout.table .center {
background: yellow;
}
.layout.table .right {
width: 300px;
background: blue;
}
</style>
<h1>三栏布局</h1>
<article class="left-center-right">
<div class="left"></div>
<div class="center">
<h2>表格布局解决方案</h2>
1.这是三栏布局的浮动解决方案; 2.这是三栏布局的浮动解决方案;
3.这是三栏布局的浮动解决方案; 4.这是三栏布局的浮动解决方案;
5.这是三栏布局的浮动解决方案; 6.这是三栏布局的浮动解决方案;
</div>
<div class="right"></div>
</article>
</section>3.2 未知宽高元素水平垂直居中
默认用 grid 或 flex,都不需要知道子元素的宽高:
/* grid:最简洁 */
.father {
  display: grid;
  place-items: center;
}

/* flex */
.father {
  display: flex;
  align-items: center;
  justify-content: center;
}
子元素需要脱离文档流(比如弹层)时,用 absolute + transform:
.father {
  position: relative;
}
.son {
  position: absolute;
  top: 50%;
  left: 50%;
  transform: translate(-50%, -50%);
}
另外 2024 年起 align-content: center 在普通块级容器(非 flex / grid)上也生效了,一行就能让块内容垂直居中。
面试时再按「是否脱离文档流、是否依赖子元素尺寸」补充几种老方案:absolute + margin: auto(子元素必须有宽高,严格来说不算未知宽高)、display: table-cell + vertical-align: middle、行内块 + 伪元素撑高 + vertical-align: middle。它们现在只在维护老代码时会遇到,写法见 HTML / CSS 笔记 · 垂直居中。
四、渲染机制
4.1 DOCTYPE
4.1.1 DOCTYPE 及 作用
DOCTYPE 是 document type(文档类型的)的简写 作用:
告诉浏览器需要通过哪一种规范(文档类型定义,DTD)解析文档(比如HTML或XHTML规范) DTD 告诉浏览器,我是什么文档类型。浏览器根据这个来判断用什么浏览引擎来解析它渲染它 DOCTYPE 就是直接告诉浏览器什么是 DTD。告诉浏览器包含哪个 DTD,也就是哪个文档类型
4.1.2 常见的 DOCTYPE 声明
<!-- HTML 5 -->
<!doctype html>

<!-- HTML 4.01 Strict -->
<!-- 这个 DTD 包含所有 HTML 元素和属性,但不包括展示性的和弃用的元素(比如 font) -->
<!DOCTYPE html PUBLIC "-//W3C//DTD HTML 4.01//EN" "http://www.w3.org/TR/html4/strict.dtd">

<!-- HTML 4.01 Transitional -->
<!-- 这个 DTD 包含所有 HTML 元素和属性,包括展示性的和弃用的元素(比如 font) -->
<!DOCTYPE html PUBLIC "-//W3C//DTD HTML 4.01 Transitional//EN" "http://www.w3.org/TR/html4/loose.dtd">
面试注意:
- 一个 strict,一个 loose。不用记怎么写。
- 知道 4.01 有两个模式,一个严格模式,一个传统模式。
- 知道 HTML5 怎么写。能说出严格和宽松的区别。
- 如果严格模式,使用了弃用的元素,页面是有问题的。宽松模式没有问题。
HTML5 已经不基于 SGML,也就没有 DTD 了,<!doctype html> 的唯一作用是让浏览器进入标准模式。缺少或写错 doctype 会进入怪异模式(quirks mode),比如盒模型按 IE 的 border-box 算、表格字体不继承等。可以在控制台用 document.compatMode 查看:CSS1Compat 是标准模式,BackCompat 是怪异模式。HTML 4.01 那两种写法现在只在维护老页面时会遇到。
4.2 浏览器渲染过程
抛出一个老生常谈的面试问题:从输入 URL 到页面加载完成,发生了什么? 首先我们需要通过 DNS域名解析,将 URL 解析为对应的 IP 地址,然后与这个 IP 地址确定的那台服务器建立起 TCP 网络连接,随后我们向服务端抛出我们的 HTTP 请求,服务端处理完我们的请求之后,把目标数据放在 HTTP 响应里返回给客户端,拿到响应数据的浏览器就可以开始走一个渲染的流程。渲染完毕,页面便呈现给了用户,并时刻等待响应用户的操作。
面试大白话解释:
输入 url,会有一个 dns 解析,然后发到服务器,服务器再响应,响应过来,到了客户端,浏览器这边就开始渲染过程
过程片段分为:
- DNS解析
- TCP连接
- HTTP请求
- service处理,HTTP响应返回
- 浏览器拿到数据,解析响应内容,展示数据内容
flowchart LR
  H[HTML] --> HP[解析 HTML] --> DOM[/生成 DOM 树/]
  C[CSS] --> CP[解析 CSS] --> CSSOM[/生成 CSSOM 树/]
  DOM --> A[合并]
  CSSOM --> A
  A --> RT[/生成渲染树/] --> L[布局] --> P[绘制] --> D([显示])
渲染过程很复杂,但是不会说的那么细。几句话说清就好了。
浏览器拿到 HTML 和 css 之后要干什么?
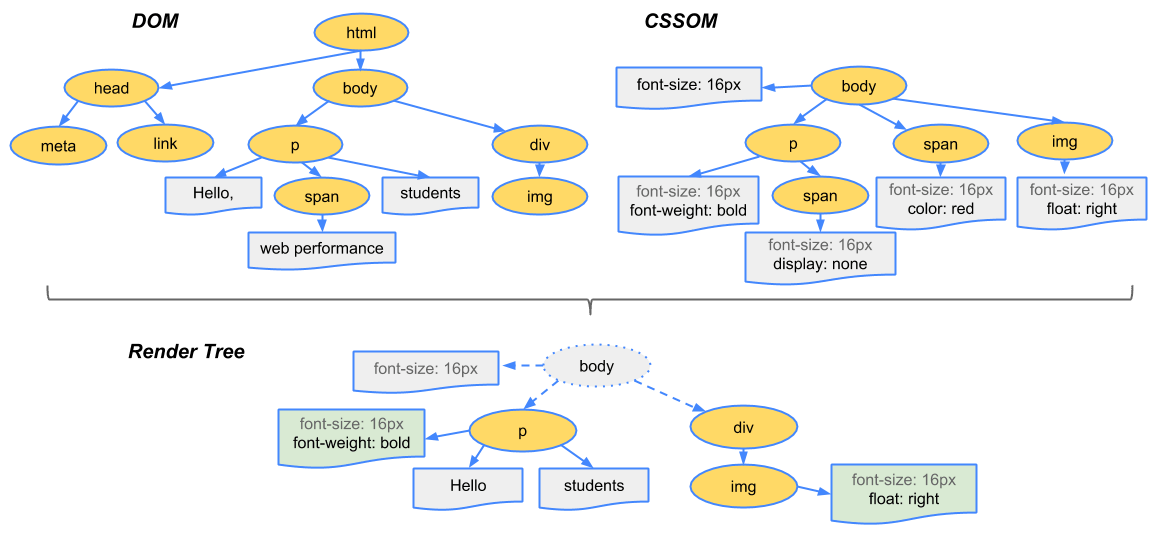
HTML 经过 HTML parser 转化成 DOM tree,css 按着 css 规则和 css 解释器,转成 CSSOM Tree,两棵树之间一整合,就是 attachment,形成一个 render tree,告诉浏览器渲染的树的结构就出来了。render tree 不包含 html 具体内容,也不知道具体位置是什么。比如有一个 div,layout 之前,不知道画在具体什么位置。这时候通过 layout 就可以精确计算到要显示的这些 dom 真正的宽高,位置颜色,最后开始 paint,画图,把内容呈现出来。最后 display,在浏览器上能看到页面效果。
CSSOM 树和 DOM 树连接在一起形成一个 render tree,渲染树用来计算可见元素的布局并且作为将像素渲染到屏幕上的过程的输入。
DOM 树和 CSSOM 树连接在一起形成 render tree .
render tree 只包含了用于渲染页面的节点布局计算了每一个对象的准确的位置以及大小绘画是最后一步,绘画要求利用 render tree 来将像素显示到屏幕上第一步是结合 DOM 树和 CSSOM 树形成“render tree”,渲染树用来描述所有可见的 DOM 内容,并且将 CSSOM 样式信息附加到节点上。
为了形成渲染树,浏览器大致做的事情有:从 DOM 树根节点开始,遍历每一个可见的节点一些节点是完全不可见的(比如 script 标签,meta 标签等),这些节点会被忽略,因为他们不会影响渲染的输出一些节点是通过 CSS 样式隐藏了,这些节点同样被忽略——例如上例中的 span 节点在 render tree 中被忽略,因为 span 样式是 display:none;对每一个可见的节点,找到合适的匹配的 CSSOM 规则,并且应用样式显示可见节点(节点包括内容和被计算的样式)
让我们快速的浏览下浏览器所做的事情:
处理 HTML 标签建立 DOM 树
处理 CSS 标签建立 CSSOM 树
连接 CSSOM 树和 DOM 树形成一个 render 树
在 render 树上运行布局来计算每个节点的形状
在屏幕上画每一个节点
虽然我们的页面很简单,但是它进行了大量的工作!
现代浏览器(以 Chromium 的 RenderingNG 为例)的渲染流水线比上面多了几步,面试时能说出来是加分项:
- Parse:HTML → DOM,CSS → CSSOM。预加载扫描器(preload scanner)会提前发现
<img>、<script>、<link>并发起请求。 - Style:计算每个节点的最终样式。
- Layout:计算几何信息,生成布局树(layout tree,也就是上面说的 render tree)。
- Paint:生成绘制指令列表,不是直接画像素。
- Composite:按图层(layer)分块光栅化,交给合成线程 / GPU 合成上屏。
关键结论:改 transform、opacity 只走 Composite,不触发 Layout 和 Paint,所以动画优先用这两个属性。另外现在问「从输入 URL 到页面展示」,还可以补充 HTTP 缓存、HTTP/2 和 HTTP/3、TLS 握手、多进程架构(浏览器进程、网络进程、渲染进程)这些点。
4.3 重绘与重排
4.3.1 重绘(repaint 或 redraw)
定义:当盒子的位置、大小以及其他属性,例如颜色、字体大小等都确定下来之后,浏览器便把这些原色都按照各自的特性绘制一遍,将内容呈现在页面上。重绘是指一个元素外观的改变所触发的浏览器行为,浏览器会根据元素的新属性重新绘制,使元素呈现新的外观。 这个过程称之为重绘。
触发重绘的条件:
- DOM 改动
- CSS 改动
4.3.2 重排(重构/回流/reflow)
定义:当渲染树中的一部分(或全部)因为元素的规模尺寸,布局,隐藏等改变而需要重新构建, 这就称为回流(reflow)。每个页面至少需要一次回流,就是在页面第一次加载的时候。
触发 Reflow:
- 当你增加、删除、修改 DOM 节点时,会导致 Reflow 或 Repaint
- 当你移动 DOM 的位置,或是搞个动画的时候
- 当你修改 CSS 样式的时候
- 当你 Resize 窗口的时候(移动端没有这个问题),或者滚动的时候
- 当你修改网页的默认字体时
注意: table 及其内部元素可能需要多次计算才能确定好其在渲染树中节点的属性值,比同等元素要多花两倍时间,这就是我们尽量避免使用 table 布局页面的原因之一。
4.3.3 重绘和重排的关系
在回流的时候,浏览器会使渲染树中受到影响的部分失效,并重新构造这部分渲染树,完成回流后,浏览器会重新绘制受影响的部分到屏幕中,该过程称为重绘。所以,重排必定会引发重绘,但重绘不一定会引发重排。
4.3.4 如何尽量减小重绘?
重绘无法避免,但是最大程度减小。比如把用户输入计算条件,把输入隐藏掉,计算结果显示出来。两个交互,用户输入,然后输入隐藏,结果展示。这个过程,呈现内容不一样了。怎么做,少画一些东西。就是要把最后的结果,放在一个节点,就算有很多结果,也不要一个一个添加,而是放在一个片段(DocumentFragment)里面,然后一次添加片段。也就是重绘一次。不然你加一个节点,重新重绘一次。
简单来说,能批量操作就批量操作。
浏览器本身会把同一帧里的多次 DOM 修改合并处理,真正的性能杀手是强制同步布局:先改样式,紧接着读 offsetHeight、getBoundingClientRect() 这类布局属性,浏览器只能立刻重新计算布局;在循环里读写交替就是「布局抖动(layout thrashing)」。应对办法:
- 读写分离,先集中读,再集中写;动画写在
requestAnimationFrame里。 - 动画用
transform/opacity,必要时加will-change(别滥用,每个图层都占内存)。 - 长列表用虚拟滚动,屏幕外的区块加
content-visibility: auto跳过渲染。 - 用
contain限制布局影响范围。
在 React / Vue 里这件事大多由框架的批量更新完成,手动操作 DOM 时才需要特别注意。
4.4 Links
渲染树构建、布局及绘制:https://web.dev/articles/critical-rendering-path/render-tree-construction
RenderingNG 架构:https://developer.chrome.com/docs/chromium/renderingng-architecture
五、页面性能
提升页面性能的方法有哪些?
- 资源压缩合并,减少 HTTP 请求 或者 避免同一时间的过多次数请求
- 非核心代码异步加载 -> 异步加载的方式 -> 异步加载的区别
- 利用浏览器缓存 -> 缓存的分类 -> 缓存的原理
- 利用 CDN
- 预解析 DNS
现在聊性能优化,面试官通常希望先听到「怎么衡量」。Google 的 Core Web Vitals 是事实标准:
- LCP(Largest Contentful Paint)最大内容绘制,衡量加载,良好线 2.5s;
- INP(Interaction to Next Paint)交互到下一帧,衡量响应,良好线 200ms,2024 年 3 月起取代了 FID;
- CLS(Cumulative Layout Shift)累计布局偏移,衡量视觉稳定,良好线 0.1。
辅助指标有 TTFB、FCP。实验室数据看 Lighthouse / DevTools Performance 面板,真实用户数据(RUM)用 web-vitals 库上报或看 CrUX。在此基础上再补充现代手段:HTTP/2 和 HTTP/3、<link rel="preload|preconnect">、fetchpriority、AVIF/WebP 图片和响应式 srcset、loading="lazy"、SSR/SSG 与流式渲染、Speculation Rules 预渲染下一页等。
5.1 资源压缩与合并
主要包括这些方面:压缩代码HTML/CSS/JS,压缩图片与其他资源,Tree-Shaking消除无用代码,以上Webpack构建项目可以搞定(Webpack 相关细节见 Webpack 学习总结)
资源压缩可以从文件中去掉多余的字符,比如回车、空格。你在编辑器中写代码的时候,会使用缩进和注释,这些方法无疑会让你的代码简洁而且易读,但它们也会在文档中添加多余的字节
5.1.1 html 压缩
html 代码压缩就是压缩这些在文本文件中有意义,但是在 HTML 中不显示的字符,包括空格,制表符,换行符等,还有一些其他意义的字符,如 HTML 注释也可以被压缩。
使用在线网站进行压缩(开发过程中一般不用)

nodejs 提供了 html-minifier 工具

后端模板引擎渲染压缩
5.1.2 css 压缩
css 代码压缩简单来说就是无效代码删除和 css 语义合并
使用在线网站进行压缩(开发过程中一般不用)

使用 html-minifier 工具

使用 clean-css 对 css 压缩
5.1.3 js 的压缩和混乱
js 的压缩和混乱主要包括以下这几部分:
- 无效字符的删除
- 剔除注释
- 代码语义的缩减和优化
- 代码保护(代码逻辑变得混乱,降低代码的可读性,这点很重要)
使用在线网站进行压缩(开发过程中一般不用)

使用 html-minifier 工具

使用 uglifyjs2 对 js 进行压缩
上面的工具名已经过时:uglify-js 不支持新语法,早被 terser 取代,现在构建工具更常用 esbuild / SWC / oxc 自带的 minifier;CSS 压缩用 cssnano 或 Lightning CSS;html-minifier 停止维护后社区用 html-minifier-terser。这些通常都内置在 Vite、Rspack、Next.js 里,不需要单独配置。传输层再叠加 gzip / Brotli(现在还有 zstd)压缩。
5.2 避免同时间段请求过多
- CSS 实现雪碧图:使用background-position共享一张图(HTTP/2 多路复用之后合并请求的收益变小,图标现在多用 SVG sprite 或 icon 组件)
- 图片懒加载:监听滚动后offsetTop, 用
data-src替换 src(真实路径)。现在直接用原生<img loading="lazy">,或用IntersectionObserver代替监听 scroll - 列表懒加载(分批加载):监听滚动后offsetTop, 发送请求加载下一页的数据(同样推荐用
IntersectionObserver观察底部的哨兵元素) - 路由懒加载
- 代码分包分块加载(webpack)
- 预加载技术
- 小程序分包、预下载
- 等
5.3 异步加载
5.3.1 动态脚本创建
在还没定义 defer 和 async 前,异步加载的方式是动态创建 script,通过 window.onload 确保页面加载完毕再将 script 标签插入到 DOM 中。具体代码如下(readyState 分支只为兼容旧 IE,现在可以删掉;动态插入的脚本默认就是 async 的)
function loadJS(url, callback) {
  let script = document.createElement('script')
  script.type = 'text/javascript'
  // IE
  if (script.readyState) {
    script.onreadystatechange = function () {
      if (script.readyState == 'loaded' || script.readyState == 'complete') {
        script.onreadystatechange = null
        if (typeof callback === 'function') {
          callback()
        }
      }
    }
  } else {
    script.onload = function () {
      if (typeof callback === 'function') {
        callback()
      }
    }
  }
  script.src = url
  document.getElementsByTagName('head')[0].appendChild(script)
}
window.onload = function () {
  loadJS('js/index.js', () => {})
}
5.3.2 defer
- 兼容所有浏览器
- defer 属性规定是否对脚本执行进行延迟,直到页面加载为止
- 如果是多个脚本,该方法可以确保所有设置了 defer 属性的脚本按顺序执行
- 如果脚本不会改变文档的内容,可将 defer 属性加入到 script 标签中,以便加快处理文档的速度
<script defer type="text/javascript" src="js/index.js"></script>5.3.3 async
- async 属性是 HTML5 新增属性,现代浏览器都支持
- async 属性规定一旦脚本可用,则会异步执行
- async 属性仅适用于外部脚本(对
type="module"的内联脚本也有效) - 如果是多个脚本,该方法不能保证脚本按顺序执行
<script async type="text/javascript" src="js/index.js"></script>5.3.4 注意
- defer 是在 HTML 解析完之后、
DOMContentLoaded之前执行,如果是多个,按照在文档中出现的顺序依次执行 - async 是在加载完之后立即执行(会打断 HTML 解析),如果是多个,执行顺序和加载顺序无关,谁先下载完谁先执行
实测补充:网上常说 defer 不会阻碍页面渲染,但在 iOS Safari 上测试时仍出现过白屏,效果和普通 script 标签一样。
现代项目里还要注意:
<script type="module">默认就是 defer 行为,再加async则变成下载完立即执行。现在用 Vite 等工具构建的项目,入口基本都是 module 脚本。- 需要调整加载优先级时用
fetchpriority="high|low",比如把首屏 LCP 图片设为 high。 - 统计、客服这类第三方脚本适合 async,或者等到
requestIdleCallback/ 用户交互后再动态加载。
5.4 浏览器缓存
浏览器缓存机制有四个方面,常见的说法是按照获取资源时请求的优先级依次排列如下:
- Memory Cache
- Service Worker Cache
- HTTP Cache
- Push Cache
Push Cache 来自 HTTP/2 Server Push,Chrome 106(2022 年)起已移除 Server Push,其他浏览器也基本不再支持,替代方案是 103 Early Hints + preload。另外严格来说 Service Worker 会先于 HTTP 缓存拦截请求,Memory Cache 是渲染进程内的短期缓存(同一页面内重复使用的资源),各浏览器实现细节不完全一致,面试时说清「SW 能完全接管请求,HTTP 缓存分强缓存和协商缓存」就够了。
HTTP 缓存是我们日常开发中最为熟悉的一种缓存机制。它又分为强缓存和协商缓存。 优先级较高的是强缓存,在命中强缓存失败的情况下,才会走协商缓存。
5.4.1 强缓存
不会向服务器发送请求,直接从缓存中读取资源,HTTP 状态码为 200(DevTools 里显示 from memory cache / from disk cache)
强缓存是利用 http 头中的 Expires 和 Cache-Control 两个字段来控制的。强缓存中,当请求再次发出时,浏览器会根据其中的 expires 和 cache-control 判断目标资源是否“命中”强缓存,若命中则直接从缓存中获取资源,不会再与服务端发生通信。
一个命中强缓存的响应头示例:
cache-control: max-age=600
content-type: image/gif
date: Sat, 29 Aug 2020 08:33:05 GMT
expires: Sat, 29 Aug 2020 08:43:05 GMT
last-modified: Mon, 20 Nov 2017 12:09:19 GMT
status: 200
5.4.1.1 expires
expires: Sat, 29 Aug 2020 08:43:05 GMT当服务端返回响应时,在 Response Header 中将过期时间写入 expires 字段中。
如上面的响应头所示:expires 存储的过期时间为 Sat, 29 Aug 2020 08:43:05 GMT,当浏览器再次加载对应资源文件时,如果在这个过期时间内,则命中强缓存。反之重新获取。
expires 问题描述:
它最大的问题在于对本地时间的依赖。 如果服务端和客户端的时间不一致,或用户手动调整了客户端时间,那么
expires将无法达到我们的预期效果。
5.4.1.2 Cache-Control
Cache-Control可在请求报文与响应报文中设置
| 指令 | 含义 |
|---|---|
| public | 响应可以被客户端和代理服务器(CDN 等共享缓存)缓存 |
| private | 响应只可以被客户端(浏览器)缓存 |
| max-age=xxx | 缓存 xx 秒后就过期,需要重新验证 |
| s-maxage=xxx | 覆盖 max-age,作用同上,只在共享缓存(代理、CDN)生效 |
| no-store | 不缓存任何响应 |
| no-cache | 可以缓存,但每次使用前都必须向服务器验证(走协商缓存) |
| must-revalidate | 过期后必须向服务器验证,不能直接用过期缓存 |
| immutable | 有效期内资源不会变,刷新页面时也不必验证 |
| stale-while-revalidate=xxx | 过期后 xx 秒内先返回旧缓存,同时在后台重新验证 |
| max-stale=xxx | (请求头)xx 秒内,即使缓存过期,也使用该缓存 |
| min-fresh=xxx | (请求头)希望在 xx 秒内获取最新的响应 |
max-age
cache-control: max-age=600如上面的响应头所示:cache-control 通过 max-age 来控制资源的有效期,value 值为时间长度,秒为单位,用数值表示。则代表在这个请求正确返回时间(浏览器也会记录下来)的 600 秒内再次加载资源,就会命中强缓存。完美地规避了时间戳带来的潜在问题。
s-maxage
细节注意:
s-maxage仅在代理服务器中生效,客户端中我们只考虑max-age
cache-control: max-age=600, s-maxage=3600s-maxage 就是用于表示 cache 服务器上(比如 cache CDN)的缓存的有效时间的,只对共享缓存有效
s-maxage 优先级高于 max-age,当两者同时出现时,共享缓存优先考虑 s-maxage
如果 s-maxage 未过期,则向代理服务器请求其缓存内容
public:所有内容都将被缓存(客户端和代理服务器都可缓存)
private:所有内容只有客户端可以缓存
Cache-Control 没有默认值。响应里既没有 Cache-Control 也没有 Expires,但带了 Last-Modified 时,浏览器会做启发式缓存,通常按 (Date - Last-Modified) × 10% 估算有效期,这也是「明明没配缓存却读到旧文件」的常见原因。
简单概括:
两者同时存在的话,Cache-Control 优先级高于 Expires
expires 与 cache-control 两者区别就在于 expires 是 HTTP/1.0 的产物,cache-control 是 HTTP/1.1 的产物。
在某些不支持 HTTP/1.1 的环境下,expires 就会发挥用处。所以 expires 其实是过时的产物,现阶段它的存在是一种向下兼容。
因此,cache-control 可以视作是 expires 的完全替代方案。
思考:
强缓存判断是否缓存的依据来自于是否超出某个时间或者某个时间段,而不关心服务器端文件是否已经更新,这可能会导致加载文件不是服务器端最新的内容,那我们如何获知服务器端内容较客户端是否已经发生了更新呢?此时我们需要协商缓存策略。
5.4.2 协商缓存
协商缓存依赖于服务端与浏览器之间的通信
协商缓存就是强制缓存失效后,浏览器携带缓存标识向服务器发起请求,服务器会根据这个请求的
request header 的一些参数来判断是否命中协商缓存,如果命中,**直接返回 304 状态码,内容为空,**并带上新的 response header 通知浏览器从缓存中读取资源;另外协商缓存需要与 cache-control 共同使用。
5.4.2.1 Last-Modified 和 If-Modified-Since
- 当第一次请求资源时,服务器将资源传递给客户端时,会将资源最后更改的时间以
Last-Modified的形式加在实体首部上一起返回给客户端; - 随后接下每次请求时,都会带上
If-Modified-Since字段的时间戳字段,值为上一次response返回给它的Last-Modified值; - 服务器接收到这个时间戳后,会比对该时间戳和资源在服务器上的最后修改时间是否一致,从而判断资源是否发生了变化。如果发生了变化,就会返回一个完整的响应内容,并在 Response Headers 中添加新的 Last-Modified 值;否则,返回如上图的 304 响应,Response Headers 不会再添加 Last-Modified 字段。
Last-Modified: Sat, 29 Aug 2020 08:43:05 GMT
If-Modified-Since: Sat, 29 Aug 2020 08:43:05 GMT
sequenceDiagram
participant B as 浏览器
participant S as 服务器
B->>S: GET /doge.png
S-->>B: 200 OK,带上 Last-Modified
B->>S: GET /doge.png,带上 If-Modified-Since
S-->>B: 304 Not Modified,响应体为空但 Last-Modified 存在一些缺点:
- 某些服务端不能获取精确的修改时间
- 文件修改时间改了,但文件内容却没有变
既然根据文件修改时间来决定是否缓存尚有不足,能否可以直接根据文件内容是否修改来决定缓存策略?如下介绍
5.4.2.2 ETag 和 If-None-Match
Etag 是上一次加载资源时,服务器返回的 response header,是对该资源的一种唯一标识,只要资源有变化,Etag 就会重新生成。浏览器在下一次加载资源向服务器发送请求时,会将上一次返回的 Etag 值放到 request header 里的 If-None-Match 里,服务器只需要比较客户端传来的 If-None-Match 跟自己服务器上该资源的 ETag 是否一致,就能很好地判断资源相对客户端而言是否被修改过了。如果服务器发现 ETag 匹配不上,那么直接以常规 GET 200 回包形式将新的资源(当然也包括了新的 ETag)发给客户端;如果 ETag 是一致的,则直接返回 304 知会客户端直接使用本地缓存即可。
sequenceDiagram
  participant C as 客户端
  participant S as 服务器
  C->>S: 请求页面 A
  S-->>C: 页面 A + ETag
  C->>S: 再次请求页面 A,带上 If-None-Match
  S->>S: 比较 ETag
  S-->>C: 304 + 空响应体
两者之间对比:
- 首先在精确度上,Etag 要优于 Last-Modified。Last-Modified 的时间单位是秒,如果某个文件在 1 秒内改变了多次,那么他们的 Last-Modified 其实并没有体现出来修改,但是 Etag 每次都会改变确保了精度;如果是负载均衡的服务器,各个服务器生成的 Last-Modified 也有可能不一致。
- 第二在性能上,Etag 要逊于 Last-Modified,毕竟 Last-Modified 只需要记录时间,而 Etag 需要服务器通过算法来计算出一个 hash 值。
- 第三在优先级上,服务器校验优先考虑 Etag
缓存的机制: 强制缓存优先于协商缓存进行,若强制缓存(Expires 和 Cache-Control)生效则直接使用缓存,若不生效则进行协商缓存(Last-Modified / If-Modified-Since 和 Etag / If-None-Match),协商缓存由服务器决定是否使用缓存,若协商缓存失效,那么代表该请求的缓存失效,重新获取请求结果,再存入浏览器缓存中;生效则返回 304,继续使用缓存。主要过程如下:
flowchart TD
  A[浏览器请求资源] --> B{有缓存吗}
  B -->|否| C[向服务器请求] --> D[返回资源和缓存标识,存入缓存] --> Z[页面加载完成]
  B -->|是| E{过期了吗,看 Cache-Control 和 Expires}
  E -->|没过期,命中强缓存| F[直接读取缓存] --> Z
  E -->|过期了| G[带上 If-None-Match 和 If-Modified-Since 向服务器请求]
  G --> H{资源有更新吗}
  H -->|没有| I[304,继续使用缓存] --> F
H -->|有| J[200,返回新资源和新标识,存入缓存] --> Z优先级:Cache-Control 高于 Expires,ETag / If-None-Match 高于 Last-Modified / If-Modified-Since。
用户行为对浏览器缓存的影响:
- 地址栏访问,链接跳转是正常用户行为,将会触发浏览器缓存机制;
- F5 刷新,浏览器会设置 max-age=0,跳过强缓存判断,会进行协商缓存判断;
- ctrl+F5 刷新,跳过强缓存和协商缓存,直接从服务器拉取资源。
Chrome 54 之后普通刷新只会重新验证主文档,子资源仍可能直接走强缓存。工程上最常见的组合是:
- 带内容哈希的静态资源(
app.3f2a1c.js):Cache-Control: public, max-age=31536000, immutable,内容变了文件名就变,永远不用验证; - HTML 入口:
Cache-Control: no-cache(配合 ETag),保证每次都能拿到最新的资源引用; - 接口数据:按业务设
no-store或短max-age+stale-while-revalidate。
这也是 Vite / Webpack 输出文件名默认带 hash 的原因。
5.4.3 其他缓存与浏览器存储
除了 HTTP 缓存,前端还能用到这些:
- Service Worker + Cache Storage:可编程的缓存,能实现离线访问(PWA)
- 浏览器存储( Cookie, LocalStorage, SessionStorage, IndexedDB )
| Cookie | LocalStorage | SessionStorage | IndexedDB | |
|---|---|---|---|---|
| 容量 | 4KB | 约 5MB | 约 5MB | 很大,按磁盘配额 |
| 生命周期 | 可设过期时间 | 永久,手动清除 | 关闭标签页清除 | 永久,手动清除 |
| 是否随请求发送 | 是 | 否 | 否 | 否 |
| API | 同步,字符串 | 同步,字符串 | 同步,字符串 | 异步,可存对象和二进制 |
5.5 CDN 优化
- 静态资源全部上 CDN,文件名带内容 hash,配合长期强缓存(
max-age=31536000, immutable) - 静态资源用独立域名,避免携带主站 Cookie
- 开启 HTTP/2、HTTP/3 和 Brotli 压缩
- 图片走 CDN 的实时处理:按设备裁剪尺寸、自动转 AVIF / WebP
- 用
<link rel="preconnect">/dns-prefetch提前和 CDN 域名建连 - 关注缓存命中率,发版时按需刷新或预热;HTML 不要长缓存
- 边缘计算(Cloudflare Workers、Vercel Edge 等)把 SSR、鉴权、A/B 测试放到离用户最近的节点
- 第三方公共 CDN 上的脚本加 SRI 校验;注意浏览器缓存早已按站点分区,「多个网站共用 CDN 上的 jQuery 可以命中缓存」这个老理由已经不成立
5.6 性能分析:Performance API
市面上的性能监控工具,主要依靠的都是 Performance API。
5.6.1 Navigation Timing:加载各阶段耗时
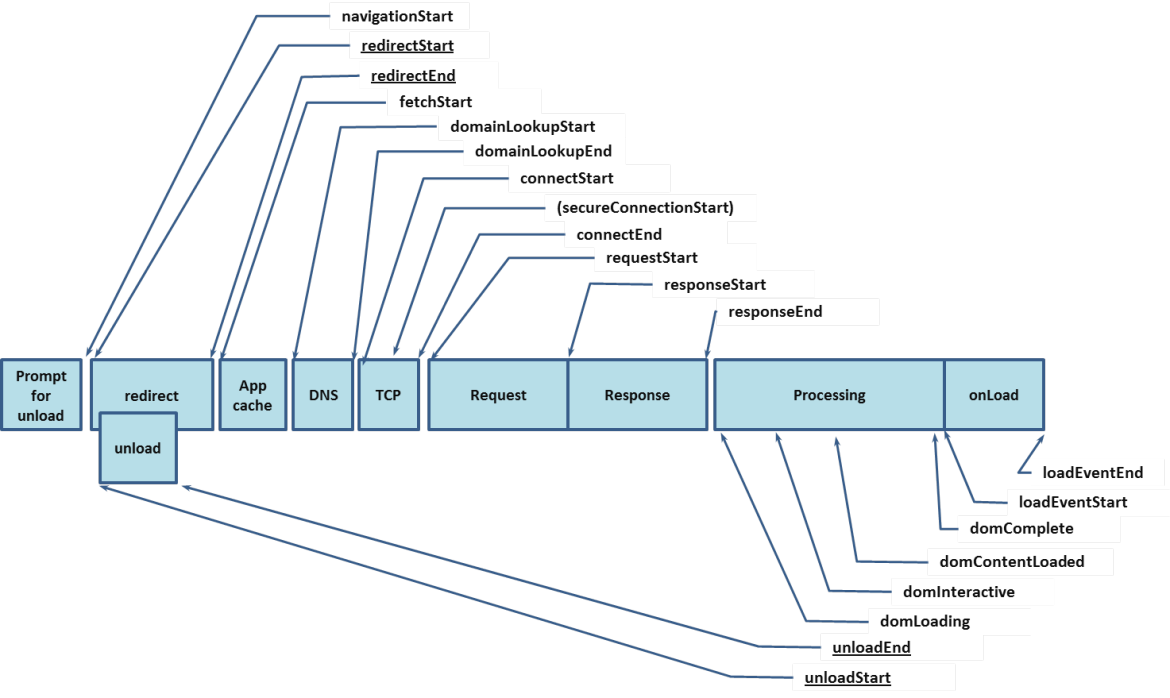
上图是页面加载过程中的关键时间点。旧的 performance.timing 已经废弃,现在用 Navigation Timing Level 2:字段名基本沿用,只是改成了相对页面开始时间(startTime 为 0)的高精度时间。
const [nav] = performance.getEntriesByType('navigation')
console.table({
  重定向: nav.redirectEnd - nav.redirectStart,
  DNS: nav.domainLookupEnd - nav.domainLookupStart,
  TCP: nav.connectEnd - nav.connectStart,
  TLS: nav.secureConnectionStart ? nav.connectEnd - nav.secureConnectionStart : 0,
  首字节TTFB: nav.responseStart - nav.startTime,
  内容下载: nav.responseEnd - nav.responseStart,
  DOM解析: nav.domInteractive - nav.responseEnd,
  DOMContentLoaded: nav.domContentLoadedEventEnd - nav.startTime,
  load: nav.loadEventEnd - nav.startTime,
})
getEntriesByType('resource') 可以拿到每个静态资源的同样一组时间,用来找出慢资源;performance.mark() / performance.measure() 用来给业务逻辑自己打点。
5.6.2 PerformanceObserver 与 web-vitals
responseStart 只能算首字节时间,真正的「白屏时间」应该看 FP / FCP。getEntriesByType 是一次性读取,拿不到之后才产生的条目,现在统一用 PerformanceObserver 订阅:
new PerformanceObserver((list) => {
  for (const entry of list.getEntries()) {
    console.log(entry.entryType, entry.name, entry.startTime)
  }
}).observe({ type: 'largest-contentful-paint', buffered: true })
// 其他常用 type:paint(FP/FCP)、layout-shift、event、longtask、long-animation-frame、resource
LCP / INP / CLS 的计算规则有不少细节,实际项目直接用 Google 的 web-vitals 库:onLCP(report)、onINP(report)、onCLS(report),每个回调还能拿到归因信息(attribution),比如 LCP 元素是哪个、慢在哪个阶段。
5.6.3 INP 与长任务
INP 统计页面整个生命周期内的交互,取接近最差的那一次(交互次数很多时会忽略少数极端值)。一次交互的耗时分三段:输入延迟(主线程正忙,事件排队等待)+ 处理时间(事件回调执行)+ 呈现延迟(样式计算、布局、绘制到下一帧)。
INP 差,绝大多数是因为主线程上有长任务(超过 50ms)。排查用 Long Animation Frames API(LoAF),它比旧的 Long Tasks API 多了归因信息,能看到是哪个脚本、哪个函数占用了这一帧。
优化手段:
- 拆分长任务,定期让出主线程,让浏览器有机会处理用户输入:
function yieldToMain() {
  // scheduler.yield 让出后会优先回到当前任务,不会被其他任务插队太久
  if (globalThis.scheduler?.yield) return scheduler.yield()
  return new Promise((resolve) => setTimeout(resolve, 0))
}

async function processAll(items) {
  let deadline = performance.now() + 50
  for (const item of items) {
    handle(item)
    if (performance.now() > deadline) {
      await yieldToMain()
      deadline = performance.now() + 50
    }
  }
}- 事件回调里先做能让界面立刻响应的更新(比如按钮状态),重活放到下一帧或
requestIdleCallback; - React 里用
useTransition把非紧急更新标为可中断; - 纯计算移到 Web Worker;
- 减少 DOM 规模,长列表用虚拟滚动,屏幕外内容用
content-visibility: auto。
5.6.4 SPA 的指标测量:软导航
Core Web Vitals 以「页面加载」为单位统计。SPA 里的路由切换(软导航)不会产生新的 LCP,这期间的 INP 和 CLS 也都算在首次加载的 URL 上,所以单看 Web Vitals 反映不了路由切换后的体验。Chrome 正在推进 Soft Navigations API 来解决这个问题;在它普及之前,RUM 需要自己在路由切换时用 performance.mark 打点,按路由统计渲染耗时。
5.6.5 图片与字体
- 图片:LCP 图片不要懒加载,加
fetchpriority="high";用srcset/sizes按屏幕下发合适尺寸;用<picture>优先下发 AVIF,WebP 和 JPEG 兜底;一定要写width/height或aspect-ratio,提前占位避免 CLS。 - 字体:关键字体用
<link rel="preload" as="font" type="font/woff2" crossorigin>提前加载,并做子集化(中文字体尤其要做);font-display: swap先显示后备字体,optional则在网络慢时直接放弃 Web 字体;用size-adjust、ascent-override把后备字体的尺寸调得和 Web 字体一致,减少字体切换时的布局偏移;可变字体一个文件包含多种字重,能减少请求数。
5.7 其他
SSR 服务器渲染:解决 SPA 框架带来的 JS 动态渲染页面带来的延迟和白屏问题。现在的选择更多:SSG 静态生成、ISR 增量再生成、流式 SSR(React 18+ 的 renderToPipeableStream)、React Server Components 减少下发到客户端的 JS,以及 Astro 这类 Islands 架构。
参考:
- Performance API MDN docs
- Performance API W3 docs
- 彻底理解浏览器的缓存机制
- 前端性能优化原理与实践
- 设计一个无懈可击的浏览器缓存方案:关于思路,细节,ServiceWorker,以及HTTP/2
六、DOM 事件
- 基本概念:DOM 事件的级别
- DOM 事件模型
- DOM 事件流
- 描述 DOM 事件捕获的具体流
- Event 对象的常见应用
- 自定义事件
- 移动端触摸事件
6.1 事件级别
// DOM0
element.onclick = function () {}

// DOM2:第三个参数 false 冒泡(默认),true 捕获
element.addEventListener('click', function () {}, false)

// DOM3:写法同 DOM2,新增了更多事件类型(键盘、鼠标滚轮、焦点、文本输入等)
element.addEventListener('keyup', function () {}, false)
addEventListener 的第三个参数现在更常传对象:
const controller = new AbortController()
element.addEventListener('scroll', onScroll, {
  capture: false,
  once: false, // true:触发一次后自动移除
  passive: true, // 承诺不调用 preventDefault,滚动 / 触摸监听加上能避免卡顿
  signal: controller.signal, // controller.abort() 一次性移除所有绑定的监听
})
在组件卸载时用 AbortController 批量解绑,是现在避免监听器泄漏的推荐写法。
6.2 事件流
flowchart TD
  W[window] -->|捕获| D[document] --> H[html] --> B[body] --> T((目标元素))
  T -.->|冒泡| B
  B -.-> H
  H -.-> D
  D -.-> W
事件流分三个阶段:捕获阶段从 window 一路向下传到目标元素(实线),然后是目标阶段,最后冒泡阶段从目标元素一路向上传回 window(虚线)。
6.3 描述 DOM 事件捕获的具体流程
window.addEventListener(
  'click',
  function (e) {
    console.log('window capture')
  },
  true
)

document.addEventListener(
  'click',
  function (e) {
    console.log('document capture')
  },
  true
)

document.documentElement.addEventListener(
  'click',
  function (e) {
    console.log('html capture')
  },
  true
)
document.body.addEventListener(
  'click',
  function (e) {
    console.log('body capture')
  },
  true
)

ev.addEventListener(
  'click',
  function (e) {
    console.log('ev capture')
  },
  true
)
6.4 Event 对象的常见应用
event.preventDefault() // 阻止默认事件(a标签)
event.stopPropagation() // 阻止冒泡
event.stopImmediatePropagation() // 同一元素绑定了多个监听,A 中调用后 B 不再执行,同时也阻止冒泡
event.currentTarget //返回绑定事件的元素
event.target //返回触发事件的元素
6.5 自定义事件(code)
var eve = new Event('custom')
ev.addEventListener('custom', function () {
  console.log('custom')
})
// 事件在哪个元素上派发,就要在哪个元素(或它的祖先,需 bubbles: true)上监听
ev.dispatchEvent(eve)

// 需要携带数据时用 CustomEvent
const detailEvent = new CustomEvent('custom-detail', {
  detail: { id: 1 },
  bubbles: true,
})
ev.addEventListener('custom-detail', (e) => console.log(e.detail)) // { id: 1 }
ev.dispatchEvent(detailEvent)
6.6 移动端触摸事件
- touchstart:当手指触碰到屏幕的时候触发
- touchmove:当手指在屏幕上滑动的时候触发
- touchend:当手指离开屏幕的时候时候触发
- touchcancel 事件:当系统停止跟踪触摸的时候触发(少用)
touches:表示当前跟踪的触摸操作的 touch 对象的数组。
targetTouches:特定于事件目标的 Touch 对象的数组。
changedTouches:表示自上次触摸以来发生了什么改变的 Touch 对象的数组。
每个 touch 对象包含的属性:
- clientX:触摸目标在视口中的 x 坐标。
- clientY:触摸目标在视口中的 y 坐标。
- identifier:标识触摸的唯一 ID。
- pageX:触摸目标在页面中的 x 坐标。
- pageY:触摸目标在页面中的 y 坐标。
- screenX:触摸目标在屏幕中的 x 坐标。
- screenY:触摸目标在屏幕中的 y 坐标。
- target:触目的 DOM 节点目标。
新代码更推荐用 Pointer Events(pointerdown / pointermove / pointerup / pointercancel),一套 API 同时处理鼠标、触摸和触控笔,通过 event.pointerType 区分来源。配合 CSS touch-action 控制浏览器默认手势。以前为了消除移动端 300ms 点击延迟引入的 FastClick,在设置了 <meta name="viewport" content="width=device-width"> 的页面上早已不需要。
6.7 冒泡
当点击一个元素触发事件时,事件会先从最外层(window)一层一层进入到触发的元素,然后再从触发元素一层一层返回到最外层,从最外层一层一层进入的阶段叫事件捕获阶段,到达目标元素叫目标阶段,从最里层一层一层往外的阶段叫事件冒泡阶段。注意 focus、blur、mouseenter、mouseleave 等事件不冒泡(可以用会冒泡的 focusin / focusout 代替)。
6.8 事件委托
事件委托就是利用事件冒泡,只指定一个事件处理程序,就可以管理某一类型的所有事件
好处:给重复的节点添加相同操作,减少 dom 交互,提高性能
实现思路:给父组件添加事件,通过事件冒泡,排查元素是否为指定元素,并进行系列操作
list.addEventListener('click', (e) => {
  // closest 能处理点在 li 内部子元素上的情况
  const item = e.target.closest('li')
  if (!item || !list.contains(item)) return
  console.log(item.dataset.id)
})
React 17+ 把事件委托挂在应用根容器上(之前是 document),这也是一种事件委托。
七、JS 运行机制
console.log(1)
setTimeout(function () {
  console.log(2)
}, 0)
console.log(3)
// 1 3 2

console.log('A')
while (1) {}
console.log('B')
// A
// while同步,永远不会执行到B(相当于一个死循环)、

console.log('A')
setTimeout(function () {
  console.log('B')
}, 0)
while (1) {}
// A
// 因为setTimeout是一个异步队列,在同步任务完成之前,任何的异步队列是不会被响应的

for (var i = 0; i < 4; i++) {
  setTimeout(function () {
    console.log(i)
  }, 1000)
}
// 4 4 4 4
// settimeout是异步执行,1000ms后往任务队列里面添加一个任务,只有主线上的全部执行完,才会执行任务队列里的任务,当主线执行完成后,i是4,所以此时再去执行任务队列里的任务时,i全部是4了。
// 对于打印4次是:每一次for循环的时候,settimeout都执行一次,但是里面的函数没有被执行,而是被放到了任务队列里面,等待执行,for循环了4次,就放了4次,当主线程执行完成后,才进入任务队列里面执行

for (let i = 0; i < 4; i++) {
  setTimeout(function () {
    console.log(i)
  }, 1000)
}
// 0 1 2 3
// let 是块级作用域,每次循环都会创建一个新的 i 绑定,回调闭包捕获的是各自那一轮的 i
7.1 JS 的单线程的概念
7.1.1 概念
JavaScript的单线程,与它的用途有关。作为浏览器脚本语言,JavaScript的主要用途是与用户互动,以及操作DOM。这决定了它只能是单线程,否则会带来很复杂的同步问题。比如,假定JavaScript同时有两个线程,一个线程在某个DOM节点上添加内容,另一个线程删除了这个节点,这时浏览器应该以哪个线程为准?所以,为了避免复杂性,从一诞生,JavaScript就是单线程,这已经成了这门语言的核心特征,将来也不会改变。
一定时间内只能执行一项任务,不能执行多项任务,为了要执行的代码,就有一个 javascript 任务队列。基于这一概念,JS 执行任务时分为两种模式:同步和异步。
“同步模式”是指后一个任务必须等待前一个任务完成后再执行,前一个任务加载时会阻塞后面程序的进行;“异步模式”不一定按顺序执行任务,所以不会阻塞程序的运行。
7.1.2 注意
Web Worker标准的提出,为了利用多核CPU的计算能力,允许JavaScript脚本创建多个线程,但是子线程完全受主线程控制,且不得操作DOM。所以没有改变JavaScript单线程的本质。
7.1.3 大白话总结
同一时间只能做一件事情
7.2 任务队列
JS 任务队列中,有两类任务队列:宏任务队列(macro tasks)和微任务队列(micro tasks)。宏任务队列可以有多个,微任务队列只有一个。那么什么任务,会分到哪个队列呢?
- 宏任务:script脚本执行(全局任务), setTimeout, setInterval, setImmediate定时事件(Node), I/O操作, MessageChannel, 用户交互事件等。
- 微任务:node中process.nextTick, Promise回调(包括 await 之后的代码), queueMicrotask, Dom变化监听MutationObserver.
(原来列的 Object.observe 提案早已撤回,UI rendering 也不算宏任务,而是事件循环中单独的渲染时机,见下文 7.3.1。)
flowchart TD
  A([任务进入执行栈]) --> B{同步还是异步}
  B -->|同步| C[进入主线程执行]
  B -->|异步| D[在 Event Table 注册回调]
  D -->|定时到期、请求返回等条件满足| E[回调进入 Event Queue]
  C --> F[主线程任务执行完毕,执行栈为空]
  F --> G[从 Event Queue 读取回调,放入主线程执行]
  E --> G
  G -->|循环往复| F
JS 运行整体流程
解释一下上图:
- 同步和异步任务分别进入不同的执行"场所",同步的进入主线程,异步的进入
Event Table并注册函数。 - 当指定的事情完成时,
Event Table会将这个函数移入Event Queue。 - 主线程内的任务执行完毕为空,会去
Event Queue读取对应的函数,进入主线程执行。 - 上述过程会不断重复,也就是常说的
Event Loop(事件循环)。
那主线程执行栈何时为空呢?js引擎存在 monitoring process 进程,会持续不断的检查主线程执行栈是否为空,一旦为空,就会去 Event Queue 那里检查是否有等待被调用的函数。
(Event Table、monitoring process 是很多中文文章里用来帮助理解的说法,并不是规范或引擎里的术语。规范里只有 task queue、microtask queue 和 event loop。)
7.3 Event Loop
浏览器的 Event Loop 遵循的是 HTML5 标准,NodeJs 的 Event Loop 遵循的是 libuv
7.3.1 浏览器
- 取一个宏任务来执行。执行完毕后,下一步
- 取一个微任务来执行,执行完毕后,再取一个微任务来执行。直到微任务队列为空(执行过程中新产生的微任务也会在这一轮清空),执行下一步
- 更新 UI 渲染:如果到了渲染时机,依次执行
requestAnimationFrame回调 → 样式计算 → 布局 → 绘制 - 如果这一帧还有空闲,执行
requestIdleCallback回调
Event Loop 会无限循环执行上面几步,这就是 Event Loop 的主要控制逻辑。其中,第 3 步(更新 UI 渲染)会根据浏览器的逻辑,决定要不要马上执行更新。一般跟随屏幕刷新率,60Hz 屏幕下约 16.7ms 一次,页面在后台时还会大幅降频。
从执行步骤来看,我们发现微任务,受到了特殊待遇!我们代码开始执行都是从 script(全局任务)开始,所以,一旦我们的全局任务(属于宏任务)执行完,就马上执行完整个微任务队列。
7.3.1.1 代码举例
Promise.resolve().then(() => {
  console.log(1)
})

// 宏任务
setTimeout(() => {
  console.log(2)
}, 0)

var s = new Date()
while (new Date() - s < 50); // 阻塞50ms

Promise.resolve().then(() => {
  console.log(3)
})

new Promise(function (resolve, reject) {
  console.log(4)
  resolve()
}).then(function () {
  console.log(5)
})

process.nextTick(function () {
  console.log(6)
})

console.log(7)
注意:
process.nextTick是 Node 的 API,这段代码要在 Node 里以 CommonJS 方式运行(比如存成.cjs),浏览器里会直接报process is not defined。
7.3.1.2 代码解释
第一轮:主线程开始执行,遇到 Promise.then() 的回调函数丢到微任务队列中,再继续执行,遇到setTimeout ,将 setTimeout 的回调函数丢到宏任务队列中,(加 50ms 的阻塞,是为了确保执行到后面时定时器已经到期,避免有人认为 setTimeout 是因为延迟没到才最后执行的。浏览器里嵌套超过 5 层的定时器最小延迟会被钳制到 4ms,Node 里 setTimeout(fn, 0) 实际是 1ms),再继续执行,遇到 Promise.then() 的回调函数丢到微任务队列中,再继续执行,在往下执行 new Promise 立即执行,输出4,then 的回调函数丢到微任务队列中,再继续执行,遇到process.nextTick,同样将回调函数扔到为任务队列,再继续执行,输出7;
当所有同步任务执行完成后看有没有可以执行的微任务,发现有 then 函数和 nextTick 两个微任务,先执行哪个呢?process.nextTick 指定的异步任务总是发生在所有异步任务之前,因此先执行process.nextTick 输出6然后执行第一个 then 函数输出1,同理输出3和输出5,第一轮执行结束;
第二轮:从宏任务队列开始,发现 setTimeout 回调,输出2执行完毕。
因此结果是: 4 7 6 1 3 5 2
同样的代码存成 .mjs 用 ESM 运行,Node 24 实测输出是 4 7 1 3 5 6 2。原因是 ESM 模块本身是在一个 Promise 任务里求值的,同步代码跑完时已经处在微任务阶段,Promise 回调会先于 nextTick 队列被清空。所以「nextTick 永远先于 Promise」这个结论只在 CommonJS 主模块里成立,回答时最好带上这个前提。
7.3.1.3 面试回答
- 首先 js 是单线程运行的,在代码执行时,通过任务进入执行栈并判断任务类型来保证代码的有序执行。
- 在执行同步代码的时候,如果遇到了异步事件,挂起该任务,继续执行执行栈中的其他任务
- 当同步事件执行完毕后,将异步事件对应的回调加入到与当前执行栈中不同的另一个任务队列中等待执行。
- 任务队列可以分为宏任务队列和微任务队列,如果当前执行栈中的事件执行完毕后,判断微任务队列中是否有任务可以执行,如果有就将微任务队首的事件压入栈中执行。
- 当微任务队列中的任务都执行完成后,浏览器视情况进行渲染,再去判断宏任务队列中的任务。
7.3.2 NodeJs
- 初始化 Event Loop
- 执行您的主代码。这里同样,遇到异步处理,就会分配给对应的队列。直到主代码执行完毕。
- 执行主代码中出现的所有微任务:先执行完所有 nextTick(),然后在执行其它所有微任务。
- 开始 Event Loop
NodeJs 的 Event Loop 分 6 个阶段执行:
     ┌───────────────────────────┐
  ┌─>│           timers          │
  │  └─────────────┬─────────────┘
  │  ┌─────────────┴─────────────┐
  │  │     pending callbacks     │
  │  └─────────────┬─────────────┘
  │  ┌─────────────┴─────────────┐
  │  │       idle, prepare       │
  │  └─────────────┬─────────────┘      ┌───────────────┐
  │  ┌─────────────┴─────────────┐      │   incoming:   │
  │  │           poll            │<─────┤  connections, │
  │  └─────────────┬─────────────┘      │   data, etc.  │
  │  ┌─────────────┴─────────────┐      └───────────────┘
  │  │           check           │
  │  └─────────────┬─────────────┘
  │  ┌─────────────┴─────────────┐
  └──┤      close callbacks      │
     └───────────────────────────┘
以上的 6 个阶段,具体处理的任务如下:
- timers: 这个阶段执行
setTimeout()和setInterval()设定的回调 - pending callbacks(I/O callbacks):会执行除了
timer,close,setImmediate之外的事件回调 - idle, prepare: 仅系统内部使用
- poll: 轮询,不断检查有没有新的
I/O callback事件,在适当的条件下会阻塞在这个阶段,主要分为如下两个步骤:- 先查看
poll queue中是否有事件,有任务就按先进先出的顺序依次执行回调 - 当
queue为空时,会检查是否有setImmediate()的callback,如果有就进入check阶段执行这些callback。但同时也会检查是否有到期的timer,如果有,就把这些到期的timer的callback按照调用顺序放到timer queue中,之后循环会进入timer阶段执行queue中的callback。
- 先查看
- check: 执行
setImmediate()设定的回调 - close callbacks: 执行比如
socket.on('close', ...)的回调
Node 11 之前,是每个阶段执行完毕后,才执行所有微任务(先 nextTick,后其它),然后再进入下一个阶段。Node 11 起改成了和浏览器一致:每执行完一个 setTimeout / setImmediate 回调,就立即清空微任务队列。
setTimeout(() => {
  console.log('t1')
  Promise.resolve().then(() => console.log('p1'))
})
setTimeout(() => {
  console.log('t2')
  Promise.resolve().then(() => console.log('p2'))
})
// Node 11+ / 浏览器:t1 p1 t2 p2
// Node 10 及以前:t1 t2 p1 p2
理解 process.nextTick() 您可能已经注意到 process.nextTick() 在关系图中没有显示,即使它是异步 API 的一部分。这是因为 process.nextTick() 在技术上不是事件循环的一部分。相反,无论事件循环的当前阶段如何,都将在当前操作完成后处理 nextTickQueue。这里的一个操作被视作为一个从 C++ 底层处理开始过渡,并且处理需要执行的 JavaScript 代码。
回顾上面关系图,任何时候在给定的阶段中调用 process.nextTick(),所有传递到 process.nextTick() 的回调将在事件循环继续之前得到解决。这可能会造成一些糟糕的情况, 因为它允许您通过进行递归 process.nextTick() 来“饿死”您的 I/O 调用,阻止事件循环到达 轮询 阶段。
7.3.2.1 和浏览器事件循环的区别
- 浏览器遵循 HTML 规范,一个宏任务 → 清空微任务 → 视情况渲染;Node 基于 libuv,分 timers、poll、check 等 6 个阶段
- Node 多了
process.nextTick(优先级高于 Promise 微任务)和setImmediate(check 阶段执行) - Node 11 之前微任务在阶段之间才清空,11 起和浏览器一致,每个回调之后就清空
- 主模块里
setTimeout(fn, 0)和setImmediate谁先执行不确定(取决于进入事件循环时 1ms 是否已到);但在 I/O 回调里一定是setImmediate先执行
7.3.2.2 check 阶段做了什么
check 阶段专门执行 setImmediate() 注册的回调。poll 阶段处理完 I/O 后,如果有 setImmediate 回调在排队,事件循环就不会在 poll 阶段阻塞等待,而是直接进入 check 阶段执行它们;每个回调执行完都会清空 nextTick 和微任务队列。check 之后是 close callbacks 阶段(socket.on('close') 等)。
7.4 Links
- JavaScript 异步、栈、事件循环、任务队列
- JavaScript:彻底理解同步、异步和事件循环(Event Loop)
- Event loops
- NodeJs 的 Event Loop 官方文档
- In The Loop - Jake Archibald(JSConf 演讲,讲浏览器事件循环和渲染时机)
八、原型链
- 创建对象的几种方法
- 原型、构造函数、实例、原型链
- instanceof 的原理
- new 运算符
8.1 创建对象的几种方法
// 第一种方式:字面量
var o1 = { name: 'o1' }
var o2 = new Object({ name: 'o2' })

// 第二种方式:构造函数
var M = function (name) {
  this.name = name
}
var o3 = new M('o3')

// 第三种方式:Object.create
var p = { name: 'p' }
var o4 = Object.create(p)

console.log(o1) // { name: 'o1' }
console.log(o2) // { name: 'o2' }
console.log(o3) // M { name: 'o3' }
console.log(o4) // {}
8.2 原型、构造函数、实例、原型链
flowchart LR
  C[构造函数] -->|prototype| P[原型对象]
  P -->|constructor| C
  C -->|new| I[实例]
  I -->|"__proto__"| P
  P -->|"__proto__"| P2[原型对象的原型,一直到 Object.prototype]
对象是函数创建的,而函数却又是一种对象。也是属性的集合,可以对函数进行自定义属性。 每个函数都有一个属性叫做 prototype。 这个 prototype 的属性值是一个对象,默认的只有一个叫做 constructor 的属性,指向这个函数本身。
var Fn = function () {
  this.name = 'WuChenDi'
  this.old = 23
}
var f1 = new Fn()
console.log(f1) // Fn { name: 'WuChenDi', old: 23 }
console.log(Fn)
console.log(Fn.prototype)
console.log(f1.__proto__ === Fn.prototype) // true
console.log(Fn.prototype.constructor === Fn) // true
从上面的代码可以看到,实例的原型指向构造函数的 prototype 属性。
f1.__proto__ 指向构造函数的 prototype 属性,就是对象的原型。所以 f1.__proto__ === Fn.prototype 为 true
prototype 的属性值是一个对象,默认的只有一个叫做 constructor 的属性,指向这个函数本身。
__proto__ 就是指向构造函数的 prototype 属性,Fn.prototype 就是对象的原型
即,每个由构造函数创建的对象都有一个 __proto__ 属性,指向创建该对象的函数的 prototype。
var 对象名 = new 函数名()
对象名.__proto__ === 函数名.prototype
原型链的终点是 Object.prototype.__proto__ === null。另外 Function.__proto__ === Function.prototype、Object.__proto__ === Function.prototype,这两个是画原型链图时最容易绕晕的地方。
__proto__ 是历史遗留的访问器,规范只是为了兼容才保留在附录里。代码里读写原型用 Object.getPrototypeOf(obj) / Object.setPrototypeOf(obj, proto),创建时指定原型用 Object.create(proto);Object.create(null) 可以得到一个没有原型的纯字典对象。
8.3 instanceof
instanceof 运算符用于检测构造函数的 prototype 属性是否出现在某个实例对象的原型链上。
flowchart LR
  I[实例对象] -->|"__proto__"| P[原型]
  C[构造函数] -->|prototype| P
  P -->|constructor| C
instanceof 判断的就是:沿着实例的 __proto__ 往上找,能不能找到构造函数的 prototype。
// 第一种方式:字面量
var o1 = { name: 'o1' }
var o2 = new Object({ name: 'o2' })

// 第二种方式:构造函数
var M = function (name) {
  this.name = name
}
var o3 = new M('o3')

// 第三种方式:Object.create
var p = { name: 'p' }
var o4 = Object.create(p)

console.log(o3 instanceof M) // true
console.log(o3 instanceof Object) // true
console.log(o3.__proto__ === M.prototype) // true
console.log(M.prototype.__proto__ === Object.prototype) // true
console.log(o3.__proto__.constructor === M) // true
手写实现:沿着左边对象的原型链往上找,直到找到右边构造函数的 prototype,或者走到链的尽头 null。
{
  // instanceof 主要的实现原理就是只要右边变量的 prototype 在左边变量的原型链上即可。因此,instanceof 在查找的过程中会遍历左边变量的原型链,直到找到右边变量的 prototype,如果查找失败,则会返回 false,告诉我们左边变量并非是右边变量的实例。
  {
    function new_instance_of(leftVaule, rightVaule) {
      let rightProto = rightVaule.prototype
      leftVaule = leftVaule.__proto__
      while (true) {
        if (leftVaule === null) return false
        if (leftVaule === rightProto) return true
        leftVaule = leftVaule.__proto__
      }
    }
  }
  {
    const new_instance_of = function (leftVaule, rightVaule) {
      // 原生 instanceof 对原始值直接返回 false(1 instanceof Number === false)
      if (leftVaule === null || (typeof leftVaule !== 'object' && typeof leftVaule !== 'function')) {
        return false
      }
      let proto = Object.getPrototypeOf(leftVaule)
      while (true) {
        if (proto == null) return false
        if (proto === rightVaule.prototype) return true
        proto = Object.getPrototypeOf(proto)
      }
    }
  }
  // 总结:使用 typeof 来判断基本数据类型是 ok 的,不过需要注意当用 typeof 来判断 null 类型时的问题,如果想要判断一个对象的具体类型可以考虑用 instanceof,但是 instanceof 也可能判断不准确,比如一个数组,他可以被 instanceof 判断为 Object。所以我们要想比较准确的判断对象实例的类型时,可以采取 Object.prototype.toString.call() 方法
  // 补充:instanceof 在跨 iframe 时会失效(每个 iframe 有自己的 Array 构造函数),判断数组用 Array.isArray;
  // 类还可以通过 static [Symbol.hasInstance]() 自定义 instanceof 的行为
}
8.4 new 运算符
- 一个新对象被创建。他继承自foo.prototype
- 构造函数 foo 被执行。执行的时候,相应的传参会被传入,同时上下文 (this) 会被指定为这个新实例。 new foo 等同于 new foo(), 只能用在不传递任何参数的情况
- 如果构造函数返回一个 "对象" ,那么这个对象会取代整个 new 出来的结果。如果构造函数没有返回对象,那么 new 出来的结果为步骤1创建的对象
// 第一种方式:字面量
var o1 = { name: 'o1' }
var o2 = new Object({ name: 'o2' })

// 第二种方式:构造函数
var M = function (name) {
  this.name = name
}
var o3 = new M('o3')

// 第三种方式:Object.create
var p = { name: 'p' }
var o4 = Object.create(p)

M.prototype.say = function () {
  console.log('say hi')
}

var o5 = new M('o5')

var new2 = function (func, ...args) {
  var o = Object.create(func.prototype)
  var k = func.apply(o, args)
  // 构造函数返回对象或函数时才替换结果;注意 typeof null 也是 'object',要排除
  if ((typeof k === 'object' && k !== null) || typeof k === 'function') {
    return k
  } else {
    return o
  }
}

var o6 = new2(M)
console.log(o6) // M { name: undefined }
console.log(new2(M, 'o7')) // M { name: 'o7' }
console.log(o6 instanceof M) // true
console.log(o6 instanceof Object) // true
console.log(o6.__proto__.constructor === M) // true

M.prototype.walk = function () {
  console.log('walk')
}

o6.walk() // walk
o3.walk() // walk
8.5 常问
8.5.1 JS 的 new 操作符做了哪些事情?
new 操作符新建了一个空对象,这个对象原型指向构造函数的 prototype,以这个对象为 this 执行构造函数;如果构造函数返回了一个对象(或函数)就用它作为结果,否则返回新建的对象。箭头函数和 class 的方法没有 [[Construct]],不能被 new。
九、面向对象
9.1 类与实例
9.1.1 类的声明
// 类的声明(es5)
var Animal = function () {
  this.name = 'Animal'
}

// 类的声明(es6)
class Animal2 {
  constructor() {
    this.name = 'Animal2'
  }
}
9.1.2 生成实例
// 类的声明(es5)
var Animal = function () {
  this.name = 'Animal'
}

// 类的声明(es6)
class Animal2 {
  constructor() {
    this.name = 'Animal2'
  }
}

// 实例化
console.log(new Animal()) // Animal { name: 'Animal' }
console.log(new Animal2()) // Animal2 { name: 'Animal2' }
9.2 继承实现
本质就是原型链
9.2.1 概念
说到继承的概念,首先要说一个经典的例子。 先定义一个类(Class)叫汽车,汽车的属性包括颜色、轮胎、品牌、速度、排气量等,由汽车这个类可以派生出“轿车”和“货车”两个类,那么可以在汽车的基础属性上,为轿车添加一个后备厢、给货车添加一个大货箱。这样轿车和货车就是不一样的,但是二者都属于汽车这个类,这样从这个例子中就能详细说明汽车、轿车以及卡车之间的继承关系。 继承可以使得子类别具有父类的各种方法和属性,比如上面的例子中“轿车” 和 “货车” 分别继承了汽车的属性,而不需要再次在“轿车”中定义汽车已经有的属性。在“轿车”继承“汽车”的同时,也可以重新定义汽车的某些属性,并重写或覆盖某些属性和方法,使其获得与“汽车”这个父类不同的属性和方法。 继承的基本概念就初步介绍这些,下面我们就来看看 JavaScript 中都有哪些实现继承的方法。
9.2.2 继承的实现方式
9.2.2.1 构造函数继承
特点: 解决了子类实例共享父类引用属性的问题 创建子类实例时,可以向父类传递参数 可以实现多继承(call多个父类对象)
缺点: 实例并不是父类的实例,只是子类的实例 只能继承父类的实例属性和方法,不能继承原型属性/方法 无法实现函数复用,每个子类都有父类实例函数的副本,影响性能
function Parent1() {
  this.name = 'parent1'
}
Parent1.prototype.say = function () {}

function Child1() {
  Parent1.call(this)
  this.type = 'child1'
}
console.log(new Child1()) // Child1 { name: 'parent1', type: 'child1' }
new Child1().say() // TypeError: ...say is not a function,拿不到原型上的方法
9.2.2.2 原型链继承
特点: 子类实例既是子类的实例,也是父类的实例 父类原型上的属性/方法,子类都能访问到
缺点: 父类实例上的引用属性被所有子类实例共享(见下面的 play 数组) 创建子类实例时,无法向父类构造函数传参 无法实现多继承
function Parent2() {
  this.name = 'parent2'
  this.play = [1, 2, 3]
}

function Child2() {
  this.type = 'child2'
}
Child2.prototype = new Parent2()

var s1 = new Child2()
var s2 = new Child2()
console.log(s1.play, s2.play) // [ 1, 2, 3 ] [ 1, 2, 3 ]
s1.play.push(4)
// TODO: 原型链中的原型对象共用
console.log(s1.play, s2.play) // [ 1, 2, 3, 4 ] [ 1, 2, 3, 4 ]
console.log(s1.__proto__ === s2.__proto__) // true
9.2.2.3 组合方式继承
特点: 解决原型链实现继承的缺点
缺点: 父级构造函数执行了两次,影响性能
function Parent3() {
  this.name = 'parent3'
  this.play = [1, 2, 3]
}

function Child3() {
  Parent3.call(this)
  this.type = 'child3'
}
Child3.prototype = new Parent3()
var s3 = new Child3()
var s4 = new Child3()
s3.play.push(4)
console.log(s3.play, s4.play) // [ 1, 2, 3, 4 ] [ 1, 2, 3 ]
9.2.2.4 组合继承 - 优化1
特点: 父类执行一次(子类实例化执行),Child4.prototype = Parent4.prototype解释(因为都是对象,都是引用类型,不会执行父级构造函数)
缺点: 如何区分一个对象是由它的子类实例化的,还是父类实例化的(s5是Child4还是Parent4直接实例化的)
function Parent4() {
  this.name = 'parent4'
  this.play = [1, 2, 3]
}

function Child4() {
  Parent4.call(this)
  this.type = 'child4'
}
Child4.prototype = Parent4.prototype
var s5 = new Child4()
var s6 = new Child4()
console.log(s5, s6) // Parent4 { name: 'parent4', play: [ 1, 2, 3 ], type: 'child4' } Parent4 { name: 'parent4', play: [ 1, 2, 3 ], type: 'child4' }

console.log(s5 instanceof Child4, s5 instanceof Parent4) // true true
console.log(s5.constructor) // [λ: Parent4]
9.2.2.5 组合继承 - 优化2
Child5.prototype = Object.create(Parent5.prototype)解释:Object.create来创建一个中间对象,把两个原型对象区分开,这个中间对象还具备一个特性,它的原型对象是父类的原型对象,这样就可以连起来,通过给Child5的原型对象的constructor做修改,就可以正常区分开父类和子类的构造函数
function Parent5() {
  this.name = 'parent5'
  this.play = [1, 2, 3]
}

function Child5() {
  Parent5.call(this)
  this.type = 'child5'
}
Child5.prototype = Object.create(Parent5.prototype)
Child5.prototype.constructor = Child5

var s7 = new Child5()
console.log(s7 instanceof Child5, s7 instanceof Parent5) // true true
console.log(s7.constructor) // [λ: Child5]这就是常说的寄生组合继承,是 ES5 下最完善的方案。
ES6 的 class Child extends Parent 在语义上就是寄生组合继承(Babel 把 class 降级出来的代码几乎和上面一样),另外还多做了两件事:Object.setPrototypeOf(Child, Parent) 让静态方法也能继承;子类必须先调 super() 才能用 this。现在写业务代码直接用 class 即可,私有字段用 #name(ES2022),静态初始化用 static {} 块。面试问「手写继承」时,答出寄生组合继承并说明它和 class 的对应关系就够了。
十、数据结构与 GC
10.1 数据类型
10.1.1 原始值类型(值类型/基本数据类型)
NumberStringBooleanNullUndefinedSymbol(ES2015)BigInt(ES2020)
(一共 7 种,Object 属于下面的引用类型。typeof null === 'object' 是历史 bug,判断 null 要用 === null。)
10.1.2 对象类型(引用数据类型)
- 标准普通对象:
object - 标准特殊对象:
Array、RegExp、Date、Math、Error…… - 非标准特殊对象(原始值的包装对象):
new Number()、new String()、new Boolean()…… - 可调用/执行对象"函数":
function
10.1.3 类型转化
显式类型强制转换是指当开发人员通过编写适当的代码用于在类型之间进行转换
Number(value)
隐式类型转换是指在对不同类型的值使用运算符时,值可以在类型之间自动的转换
1 == null
在 JS 中只有 3 种类型的转换
- 转化为
Number类型:Number()/parseFloat()/parseInt() - 转化为
String类型:String()/toString() - 转化为
Boolean类型:Boolean()
10.1.4 堆/栈
- JS 就是动态语言,因为在声明变量之前并不需要确认其数据类型,所以 JS 的变量是没有数据类型的,值才有数据类型,变量可以随时持有任何类型的数据。
- JS 数据类型可分为两大类——基本类型和引用类型。
- 基本类型的数据是存放在栈中,引用类型的数据是存放在堆中的。
- 堆中的数据是通过引用和变量关联起来的。
- 闭包除外,JS 闭包中的变量值并不保存在栈内存中,而是保存在堆内存中。
「基本类型在栈、引用类型在堆」是便于理解的简化模型。实际 V8 里只有小整数(Smi)会直接存在栈/寄存器里,字符串、浮点数、BigInt 等也都是堆上对象。面试按简化模型回答即可,被追问时能说出这一点更好。
10.2 垃圾回收
10.2.1 什么是垃圾回收?
10.2.1.1 手动回收和自动回收
通常情况下,垃圾数据回收分为手动回收和自动回收两种策略。
手动回收
例如以前学 C 的时候,何时分配内存、何时销毁内存都是由代码控制的,如下:
#include <stdlib.h>

int main() {
  // 手动申请一块能放 10 个 int 的内存
  int *arr = (int *)malloc(sizeof(int) * 10);
  arr[0] = 1;
  // 用完必须手动释放,忘了就是内存泄漏,释放后再访问就是野指针
  free(arr);
  return 0;
}
自动回收
自动垃圾回收的策略,如 JavaScript,产生的垃圾数据是由垃圾回收器来释放的,并不需要手动通过代码来释放。下面记录几个小疑惑。
- **对于栈中的垃圾回收,**JS 引擎通过向下移动
ESP(extended stack pointer当前执行状态针)指针(记录调用栈当前执行状态的指针),来销毁该函数保存在栈中的执行上下文(变量环境、词法环境、this、outer),这里是不需要通过V8的垃圾回收机制的,效率非常高。 - **对于堆中的垃圾回收,**主要通过副垃圾回收器(新生代)和主垃圾回收器(老生代)负责的,副垃圾回收器采用
scavenge算法将区域分为对象区域和空闲区域,通过两个区域的反转让新生代区域无限使用下去。主垃圾回收器采用Mark-Sweep(Mark-Compact Incremental Marking解决不同场景下问题的算法改进)算法进行空间回收的。无论是主副垃圾回收器的策略都是标记-清除-整理三个大的步骤。另外还有新生代的晋升策略(两次未清除的),大对象直接分配在老生代。
10.2.1.2 新生代和老生代
新生代
算法:
Scavenge算法
原理:
- 把新生代空间对半划分为两个区域,一半是对象区域,一半是空闲区域。
- 新加入的对象都会存放到对象区域,当对象区域快被写满时,就需要执行一次垃圾清理操作。
- 先对对象区域中的垃圾做标记,标记完成之后,把这些存活的对象复制到空闲区域中
- 完成复制后,对象区域与空闲区域进行角色翻转,也就是原来的对象区域变成空闲区域,原来的空闲区域变成了对象区域。
对象晋升策略:经过两次垃圾回收依然还存活的对象,会被移动到老生区中。
老生代
算法:标记 - 清除(
Mark-Sweep)算法
原理:
- 标记:标记阶段就是从一组根元素开始,递归遍历这组根元素,在这个遍历过程中,能到达的元素称为活动对象,没有到达的元素就可以判断为垃圾数据。
- 清除:将垃圾数据进行清除。
- 碎片:对一块内存多次执行标记 - 清除算法后,会产生大量不连续的内存碎片。而碎片过多会导致大对象无法分配到足够的连续内存。
算法:标记 - 整理(
Mark-Compact)算法
原理:
- 标记:和标记 - 清除的标记过程一样,从一组根元素开始,递归遍历这组根元素,在这个遍历过程中,能到达的元素标记为活动对象。
- 整理:让所有存活的对象都向内存的一端移动
- 清除:清理掉端边界以外的内存
优化算法:增量标记(
Incremental Marking)算法
原理:
- 为了降低老生代的垃圾回收而造成的卡顿
- V8把一个完整的垃圾回收任务拆分为很多小的任务
- 让垃圾回收标记和 JavaScript 应用逻辑交替进行
V8 现在的垃圾回收器叫 Orinoco,在上面三种算法基础上大量使用多线程:新生代用并行 Scavenge(多个辅助线程同时复制存活对象);老生代用并发标记(标记工作主要在后台线程完成,主线程几乎不停顿)、并发 / 惰性清除,只有整理阶段需要短暂暂停主线程。另外还有空闲时 GC(利用帧间空闲时间回收)。面试时能说出「分代 + 增量 + 并行 + 并发」这几个关键词就够了。
10.2.2 判断内存泄漏
- 可能长时间运行页面卡顿,感官上猜测可能会有内存泄漏,通过 Chrome DevTools 的
Performance、Memory面板收集数据。 - 在页面进行各种交互,在一定的时间内(越长越好),生成统计数据,观察内存变化(
timeline),如变化规律为周期且平稳的,则不存在泄漏可能。但是变化趋势是向上,就存在内部泄漏的可能! - 统计图表里的
JS heap、Documents、Nodes、Listeners分别对应 JS 堆内存、文档数、DOM 节点数、事件监听器数。哪条曲线只涨不降,就往对应方向排查。 - 确认有泄漏后,用
Memory面板在操作前后各拍一次堆快照(Heap Snapshot),选 Comparison 视图看新增了哪些对象,再通过 Retainers 找到是谁引用着它。
10.2.3 工作中避免内存泄漏
常见的泄漏来源:
- 意外的全局变量(非严格模式下给未声明变量赋值)
- 忘记清除的
setInterval/setTimeout - 组件卸载时没有移除的事件监听、订阅、
IntersectionObserver/ResizeObserver - 已经从 DOM 树上移除、但仍被 JS 变量引用的 DOM 节点(detached DOM)
- 闭包无意间持有了大对象,或者无限增长的缓存 Map
对应的做法:
- 确定不使用的临时变量置为
null - 在 React
useEffect的清理函数、VueonUnmounted里成对释放定时器、监听和订阅,监听可以统一用AbortController解绑 - 以对象为 key 的缓存用
WeakMap/WeakSet,key 被回收时条目会自动消失;需要弱引用时用WeakRef+FinalizationRegistry - 缓存设上限(LRU)
10.3 闭包
闭包就是能够读取其他函数内部变量的函数,或者子函数在外调用,子函数所在的父函数的作用域不会被释放。 当在一个函数内定义另外一个函数就会产生闭包。
10.3.1 作用
为什么要用: 匿名自执行函数:我们知道所有的变量,如果不加上 var 关键字,则默认的会添加到全局对象的属性上去,这样的临时变量加入全局对象有很多坏处,比如:别的函数可能误用这些变量;造成全局对象过于庞大,影响访问速度(因为变量的取值是需要沿着作用域链逐层查找的,全局变量在链的最末端)。除了每次使用变量都是用 var 关键字外,我们在实际情况下经常遇到这样一种情况,即有的函数只需要执行一次,其内部变量无需维护,可以用闭包。
结果缓存:我们开发中会碰到很多情况,设想我们有一个处理过程很耗时的函数对象,每次调用都会花费很长时间,那么我们就需要将计算出来的值存储起来,当调用这个函数的时候,首先在缓存中查找,如果找不到,则进行计算,然后更新缓存并返回值,如果找到了,直接返回查找到的值即可。闭包正是可以做到这一点,因为它不会释放外部的引用,从而函数内部的值可以得以保留。
function memoize(fn) {
  const cache = new Map()
  return function (arg) {
    if (!cache.has(arg)) cache.set(arg, fn(arg))
    return cache.get(arg)
  }
}
其他常见用途:封装私有状态(模块模式)、柯里化 / 偏函数、防抖节流(见 17.1.15)。React Hooks 的「过期闭包」问题也是常考点:useEffect 或定时器回调捕获的是创建时那一次渲染的 state,依赖数组没写全就会读到旧值。
有了 ES Module 和块级作用域,用 IIFE 隔离变量的需求基本没有了,但闭包本身是 JS 函数的基础机制,谈不上「少用」。要注意的只是别让长生命周期的闭包(比如全局事件回调)引用用完就该释放的大对象。
10.4 Links
浏览器工作原理与实践:https://time.geekbang.org/column/article/131233
V8 博客 - Trash talk: the Orinoco garbage collector:https://v8.dev/blog/trash-talk
十一、TypeScript
TypeScript 在中高级前端面试里已经是默认技能,基础语法很少单独考,区分度在两个方向:类型编程(能不能读懂、写出工具类型)和业务类型设计(能不能用类型把业务约束表达清楚)。
本章的类型示例都用 TypeScript 7 的 tsc --strict 检查通过。为了直接展示类型推导的结果,借用了 type-challenges 里的两个测试工具:Expect<Equal<A, B>> 能编译通过,就说明 A 和 B 完全相同;// @ts-expect-error 标记的那一行本来就应该报错。
type Equal<X, Y> = (<T>() => T extends X ? 1 : 2) extends <T>() => T extends Y ? 1 : 2 ? true : false
type Expect<T extends true> = T
11.1 基础
11.1.1 type 和 interface
- interface 只能描述对象(包括函数和类的形状),支持
extends继承和声明合并(同名 interface 会自动合并,常用来扩展第三方库的类型,比如给Window加属性)。 - type 是类型别名,能表示任何类型:联合、交叉、元组、条件类型、映射类型等。
- 描述对象时两者基本可以互换,团队统一一种即可。常见约定是对外暴露、可能被扩展的对象类型用 interface,其余用 type。
11.1.2 any、unknown、never
| 含义 | 用法 | |
|---|---|---|
any | 关闭类型检查,可以赋给任何类型、调用任何方法 | 尽量不用,迁移老代码时临时使用 |
unknown | 安全的顶层类型,任何值都能赋给它,但使用前必须先收窄 | 接收外部数据、catch 里的错误 |
never | 空类型,没有任何值 | 穷尽检查、抛错或死循环函数的返回值、在条件类型里过滤成员 |
void 表示函数没有有意义的返回值;object 表示非原始值;{} 表示除 null 和 undefined 以外的任何值,不要把它当作「空对象」使用。
11.1.3 类型收窄
TypeScript 会根据控制流自动收窄联合类型。收窄的手段有 typeof、instanceof、in、字面量比较、判别字段,以及自定义的类型谓词(is)和断言函数(asserts):
function format(input: string | number | Date) {
  if (typeof input === 'string') return input.trim()
  if (typeof input === 'number') return input.toFixed(2)
  return input.toISOString() // 这里 input 已被收窄为 Date
}

interface Fish { swim(): void }
interface Bird { fly(): void }
function isFish(pet: Fish | Bird): pet is Fish {
  return 'swim' in pet
}
function move(pet: Fish | Bird) {
  if (isFish(pet)) pet.swim()
  else pet.fly()
}

function assertIsString(value: unknown): asserts value is string {
  if (typeof value !== 'string') throw new TypeError('not a string')
}
function parse(raw: unknown) {
  assertIsString(raw)
  return raw.toUpperCase() // 断言之后 raw 是 string
}
11.2 泛型
泛型就是类型的参数。用 extends 约束泛型的范围,keyof 取对象所有键组成的联合类型,T[K] 取对应属性的类型(索引访问类型):
function getProp<T, K extends keyof T>(obj: T, key: K): T[K] {
  return obj[key]
}
const user = { name: 'wudi', age: 30 }
const n = getProp(user, 'name') // string
type _g1 = Expect<Equal<typeof n, string>>
// @ts-expect-error 'email' 不在 keyof typeof user 里
getProp(user, 'email')

function longest<T extends { length: number }>(a: T, b: T): T {
  return a.length >= b.length ? a : b
}
longest('abc', 'de')
longest([1, 2], [3])
什么时候需要泛型:返回值类型依赖参数类型的时候。如果泛型参数只出现一次(比如 function f<T>(x: T): void),它就没有意义,直接写成 unknown 即可。
11.3 条件类型与 infer
条件类型 T extends U ? X : Y 是类型层面的三元表达式。两个重点:
- 分发:当
T是裸类型参数、传入的又是联合类型时,条件类型会对联合的每个成员分别求值再合并。不想分发时,用[T]把它包起来。 - infer:在
extends子句里声明一个待推断的类型变量,用来「提取」类型的一部分。内置的ReturnType、Parameters、Awaited都是这样实现的。
type IsString<T> = T extends string ? true : false
type _c1 = Expect<Equal<IsString<'a'>, true>>
type _c2 = Expect<Equal<IsString<string | number>, boolean>> // 分发:true | false

type NoDistribute<T> = [T] extends [string] ? true : false
type _c3 = Expect<Equal<NoDistribute<string | number>, false>>

type MyReturnType<T> = T extends (...args: any[]) => infer R ? R : never
type MyParameters<T> = T extends (...args: infer P) => any ? P : never
type MyAwaited<T> = T extends PromiseLike<infer V> ? MyAwaited<V> : T
type ElementOf<T> = T extends readonly (infer E)[] ? E : never

declare function fetchUser(id: number, withPosts?: boolean): Promise<{ id: number }>
type _c4 = Expect<Equal<MyReturnType<typeof fetchUser>, Promise<{ id: number }>>>
type _c5 = Expect<Equal<MyParameters<typeof fetchUser>, [id: number, withPosts?: boolean]>>
type _c6 = Expect<Equal<MyAwaited<Promise<Promise<string>>>, string>>
type _c7 = Expect<Equal<ElementOf<string[]>, string>>
11.4 映射类型与模板字面量类型
映射类型遍历一个联合类型(通常是 keyof T)生成新的对象类型,as 子句可以重映射或过滤键(映射成 never 的键会被去掉)。模板字面量类型在类型层面拼接字符串,配合 infer 还能解析字符串:
type Getters<T> = {
  [K in keyof T as `get${Capitalize<string & K>}`]: () => T[K]
}
type _m1 = Expect<Equal<Getters<{ name: string; age: number }>, { getName: () => string; getAge: () => number }>>

type OmitByValue<T, V> = { [K in keyof T as T[K] extends V ? never : K]: T[K] }
type _m2 = Expect<Equal<OmitByValue<{ a: string; b: number; c: () => void }, Function>, { a: string; b: number }>>

type EventName<T extends string> = `on${Capitalize<T>}`
type _m3 = Expect<Equal<EventName<'click' | 'focus'>, 'onClick' | 'onFocus'>>

type CssSize = `${number}${'px' | 'rem' | '%'}`
const w: CssSize = '100px'
// @ts-expect-error 单位不合法
const bad: CssSize = '100pt'

// 从路由字符串里提取参数名
type RouteParams<S extends string> = S extends `${string}:${infer P}/${infer Rest}`
  ? P | RouteParams<`/${Rest}`>
  : S extends `${string}:${infer P}`
    ? P
    : never
type _m4 = Expect<Equal<RouteParams<'/users/:id/posts/:postId'>, 'id' | 'postId'>>
11.5 手写工具类型
面试最常让手写的是这几个,核心就是映射类型、修饰符(?、readonly 前面加 - 表示去掉)和条件类型:
type MyPartial<T> = { [K in keyof T]?: T[K] }
type MyRequired<T> = { [K in keyof T]-?: T[K] }
type MyReadonly<T> = { readonly [K in keyof T]: T[K] }
type Mutable<T> = { -readonly [K in keyof T]: T[K] }
type MyPick<T, K extends keyof T> = { [P in K]: T[P] }
type MyRecord<K extends keyof any, V> = { [P in K]: V }
type MyExclude<T, U> = T extends U ? never : T
type MyExtract<T, U> = T extends U ? T : never
type MyOmit<T, K extends keyof any> = MyPick<T, MyExclude<keyof T, K>>
type MyNonNullable<T> = T & {}

type DeepPartial<T> = T extends (...args: any[]) => any
  ? T
  : T extends object
    ? { [K in keyof T]?: DeepPartial<T[K]> }
    : T
type DeepReadonly<T> = T extends (...args: any[]) => any
  ? T
  : T extends object
    ? { readonly [K in keyof T]: DeepReadonly<T[K]> }
    : T

interface Todo { title: string; done: boolean; meta?: { tags: string[] } }
type _u1 = Expect<Equal<MyPartial<Todo>, Partial<Todo>>>
type _u2 = Expect<Equal<MyRequired<Todo>, Required<Todo>>>
type _u3 = Expect<Equal<MyPick<Todo, 'title'>, Pick<Todo, 'title'>>>
type _u4 = Expect<Equal<MyOmit<Todo, 'done'>, Omit<Todo, 'done'>>>
type _u5 = Expect<Equal<MyExclude<'a' | 'b' | 'c', 'a'>, 'b' | 'c'>>
type _u6 = Expect<Equal<MyNonNullable<string | null | undefined>, string>>
type _u7 = Expect<Equal<MyRecord<'x' | 'y', number>, Record<'x' | 'y', number>>>
type _u8 = Expect<Equal<Mutable<Readonly<Todo>>, Todo>>
const patch: DeepPartial<Todo> = { meta: {} } // 嵌套对象也变成可选
Omit 的 K 约束是 keyof any 而不是 keyof T,所以传入不存在的键不会报错,这是内置 Omit 的一个常见坑。需要严格检查时可以自己定义 StrictOmit<T, K extends keyof T>。
11.6 satisfies、as const 与判别联合
type Color = 'red' | 'green'
const palette = {
  red: '#f00',
  green: [0, 255, 0],
} satisfies Record<Color, string | number[]>
palette.red.toUpperCase() // satisfies 保留了推断:red 是 string
palette.green.map((c) => c * 2) // green 是 number[]

const annotated: Record<Color, string | number[]> = { red: '#f00', green: [0, 255, 0] }
// @ts-expect-error 类型注解会丢掉具体信息,这里只知道是 string | number[]
annotated.red.toUpperCase()

const ROLES = ['admin', 'editor', 'viewer'] as const
type Role = (typeof ROLES)[number]
type _s1 = Expect<Equal<Role, 'admin' | 'editor' | 'viewer'>>

type RequestState<T> =
  | { status: 'idle' }
  | { status: 'loading' }
  | { status: 'success'; data: T }
  | { status: 'error'; error: Error }

function render(state: RequestState<string[]>) {
  switch (state.status) {
    case 'idle':
      return '未开始'
    case 'loading':
      return '加载中'
    case 'success':
      return state.data.join(',') // 这里能访问 data
    case 'error':
      return state.error.message
    default: {
      // 新增一种 status 却忘了处理时,这里会编译报错
      const exhaustive: never = state
      return exhaustive
    }
  }
}satisfies:检查值是否符合某个类型,但变量的类型仍然是推断出来的具体类型。相比类型注解,它不会把信息「放宽」掉,适合写配置对象。as const:把字面量推断为只读的最窄类型,常用来从常量数组派生联合类型,让枚举值只维护一份。- 判别联合:联合的每个成员都有一个字面量类型的公共字段,
switch这个字段时 TypeScript 能自动收窄到具体成员。在default分支把值赋给never就是穷尽检查,新增成员却忘了处理时会编译报错。这种写法比一堆可选字段(data?、error?)更能防止出现「既成功又失败」的非法状态。
11.7 业务类型设计
type Brand<T, B extends string> = T & { readonly __brand: B }
type UserId = Brand<string, 'UserId'>
type OrderId = Brand<string, 'OrderId'>
const toUserId = (id: string) => id as UserId
declare function getOrder(id: OrderId): void
// @ts-expect-error UserId 不能传给需要 OrderId 的地方
getOrder(toUserId('u_1'))

interface ApiResponse<T> { code: number; message: string; data: T }
declare function request<T>(url: string): Promise<ApiResponse<T>>
async function loadUsers() {
  const res = await request<{ id: number; name: string }[]>('/api/users')
  return res.data.map((u) => u.name)
}

// 函数重载:返回类型依赖参数时比联合类型更精确
function createElement(tag: 'a'): HTMLAnchorElement
function createElement(tag: 'img'): HTMLImageElement
function createElement(tag: string): HTMLElement
function createElement(tag: string) {
  return document.createElement(tag)
}
const a = createElement('a') // HTMLAnchorElement
type _b1 = Expect<Equal<typeof a, HTMLAnchorElement>>
几个实用原则:
- 让非法状态无法表示:用判别联合代替多个可选字段和布尔标记。
- 品牌类型(branded type):结构相同但语义不同的值(用户 ID 和订单 ID 都是字符串),加一个只存在于类型层面的标记,防止传错。
- 从单一来源推导:类型从常量(
as const)、schema 或接口定义推导出来,不要手写两份再靠人工同步。 - 类型只在编译期存在:接口返回、
JSON.parse、表单输入这些外部数据,类型注解只是「假设」。真正的校验要在运行时做,用 zod / valibot 定义 schema,类型从 schema 推导:
import { z } from 'zod'

const UserSchema = z.object({
  id: z.number(),
  name: z.string().min(1),
  role: z.enum(['admin', 'editor', 'viewer']),
})
type User = z.infer<typeof UserSchema> // 类型从 schema 推导,只维护一份

const result = UserSchema.safeParse(await res.json())
if (!result.success) throw new Error(result.error.message)
const user: User = result.data
11.8 与框架结合
11.8.1 React
import type { ChangeEvent, ComponentProps, ReactNode } from 'react'
import { useRef, useState } from 'react'

// 继承原生 button 的全部属性,再加自己的
type ButtonProps = ComponentProps<'button'> & { variant?: 'primary' | 'ghost' }
function Button({ variant = 'primary', ...props }: ButtonProps) {
  return <button data-variant={variant} {...props} />
}

// 泛型组件:renderItem 的参数类型由 items 自动推断
type ListProps<T> = {
  items: T[]
  getKey: (item: T) => string
  renderItem: (item: T) => ReactNode
}
function List<T>({ items, getKey, renderItem }: ListProps<T>) {
  return <ul>{items.map((item) => <li key={getKey(item)}>{renderItem(item)}</li>)}</ul>
}

// React 19:ref 直接作为 prop 传入,不再需要 forwardRef
function TextInput({ ref, ...props }: ComponentProps<'input'>) {
  return <input ref={ref} {...props} />
}

export function Demo() {
  const inputRef = useRef<HTMLInputElement>(null)
  const [value, setValue] = useState('')
  const onChange = (e: ChangeEvent<HTMLInputElement>) => setValue(e.target.value)
  return (
    <>
      <TextInput ref={inputRef} value={value} onChange={onChange} />
      <Button variant="ghost" onClick={() => inputRef.current?.focus()}>聚焦</Button>
      <List
        items={[{ id: 'a', name: 'React' }]}
        getKey={(item) => item.id}
        renderItem={(item) => item.name.toUpperCase()}
      />
    </>
  )
}
要点:组件 props 用 ComponentProps<'button'> 继承原生属性,不用手写;泛型组件让回调参数的类型跟着数据走;React 19 起 ref 是普通 prop,forwardRef 不再需要;useRef<HTMLInputElement>(null) 得到的 current 可能为 null,使用时要判断。
11.8.2 Vue
Vue 3 的 <script setup lang="ts"> 里,props、emits 和 model 都可以直接用类型声明:
<script setup lang="ts" generic="T extends { id: string }">
const props = withDefaults(
  defineProps<{
    items: T[]
    size?: 'small' | 'large'
  }>(),
  { size: 'small' },
)

const emit = defineEmits<{
  select: [item: T] // 具名元组:事件参数的类型
}>()

const keyword = defineModel<string>('keyword', { default: '' })
</script>
Vue 3.3 起支持 generic 属性写泛型组件;3.5 起 props 可以直接解构并保留响应式(const { size = 'small' } = defineProps<...>())。模板里的类型检查要用 vue-tsc(或 Volar 编辑器插件)。
11.9 工具链
- TypeScript 7:编译器用 Go 重写的原生实现,大型项目的类型检查和编辑器响应快了约 10 倍,命令仍然是
tsc。 - 构建工具只擦除类型:Vite、esbuild、SWC、Babel 只负责去掉类型,不做检查,所以 CI 里要单独跑
tsc --noEmit。开启isolatedModules可以保证每个文件都能被单独转译。 - Node 直接运行 TS:Node 22.18 / 23.6 起默认支持类型擦除,
node app.ts就能跑。前提是只用「可擦除」的语法:enum、namespace、构造函数参数属性这些会生成运行时代码的特性不行,可以开启erasableSyntaxOnly让编译器检查。这也是越来越多团队用as const对象代替enum的原因。 - tsconfig 推荐开启:
strict;noUncheckedIndexedAccess(按下标访问数组和索引签名时结果带上undefined);verbatimModuleSyntax(只导入类型时必须写import type);前端项目用"moduleResolution": "bundler"。
11.10 常见问题速答
interface和type怎么选? 见 type 和 interface。enum还要用吗? 数字 enum 有反向映射、会生成运行时代码,也不兼容 Node 的类型擦除。推荐用as const对象 +keyof typeof派生联合类型。Record<string, T>和索引签名有什么区别? 等价。注意按任意 key 读取时类型不包含undefined,开启noUncheckedIndexedAccess才安全。- 协变和逆变? 对象属性和返回值是协变的(子类型可以赋给父类型);函数参数在
strictFunctionTypes下是逆变的(参数类型要更宽)。但用方法简写语法(method(x: T): void)声明的参数是双变的,这是为了兼容数组等内置类型而保留的不严谨之处。 .d.ts是干什么的? 只包含类型声明,给 JS 库补类型,或者库发布时提供类型;declare module 'xxx'给没有类型的模块声明类型,declare global扩展全局类型。- 类型体操有上限吗? 有。递归类型有深度限制,过于复杂的类型会拖慢编辑器。业务代码里的类型以可读为先,复杂的类型逻辑封装在少数工具类型里,并配上类型测试。
十二、Virtual DOM
Virtual DOM 就是用 JS 对象去 模拟 DOM 结构,它是真实 DOM 的抽象,只保留一些有用的信息,更轻量地描述 DOM 树的结构;新旧 vnode 对比,得出最小的更新范围,最后更新 DOM;数据驱动视图的模式下,有效控制 DOM 操作。
12.1 简单虚拟 DOM 结构
12.1.1 DOM 节点
<div id="app" class="container">
  <p>我是p标签</p>
  <ul style="background-color: red">
    <li>我是a标签</li>
  </ul>
</div>
12.1.2 js模拟 vnode 节点
const vnode = {
	tag: "div",
	props: {
		className: "container",
		id: "app",
	},
	children: [
		{
			tag: "p",
			children: "我是p标签",
		},
		{
			tag: "ul",
			props: { style: "background-color: red" },
			children: [
				{
					tag: "li",
					children: "我是a标签",
				},
			],
		},
	],
}
12.2 snabbdom使用
案例代码:https://github.com/wuchendi/Front-End/tree/master/12-snabbdom/virtual-dom
12.2.1 index.html
<!doctype html>
<html lang="en">
  <head>
    <meta charset="UTF-8" />
    <meta http-equiv="X-UA-Compatible" content="IE=edge" />
    <meta name="viewport" content="width=device-width, initial-scale=1.0" />
    <title>snabbdom</title>
  </head>
  <body>
    <div id="app">app</div>
    <div id="container">container</div>
    <button id="btn-change">change</button>
    <script src="./src/index.js"></script>
  </body>
</html>
12.2.2 index.js
// index.js(snabbdom v3)
import {
  init,
  h,
  classModule,
  propsModule,
  styleModule,
  eventListenersModule,
} from 'snabbdom'

// 例 1:替换根节点
{
  const patch = init([])

  let vnode = h('div', 'Hello World')
  const app = document.querySelector('#app')
  const oldVnode = patch(app, vnode)

  vnode = h('div#dd', 'Hello cdd')
  patch(oldVnode, vnode)
}

// 例 2:更新子节点
{
  const patch = init([])

  const vnode = h('div#container', [
    h('h1', '我是h1标签'),
    h('ul', [h('li', '我是li标签')]),
  ])

  const app = document.querySelector('#app')
  patch(app, vnode)

  setTimeout(() => {
    const newVnode = h('div#container', [h('h2', '我是h2标签')])
    patch(vnode, newVnode)
  }, 2000)

  // 传入注释节点 h('!') 可以清空内容
  // setTimeout(() => patch(vnode, h('!')), 2000)
}

// 例 3:带模块的列表更新
{
  // 定义 patch
  const patch = init([classModule, propsModule, styleModule, eventListenersModule])

  const container = document.getElementById('container')

  // 生成 vnode
  const vnode = h('ul#list', {}, [h('li.item', {}, 'Item 1'), h('li.item', {}, 'Item 2')])

  patch(container, vnode)

  document.getElementById('btn-change').addEventListener('click', () => {
    // 生成 newVnode
    const newVnode = h('ul#list', {}, [
      h('li.item', {}, 'Item 1'),
      h('li.item', {}, 'Item B'),
      h('li.item', {}, 'Item 3'),
    ])
    patch(vnode, newVnode)
  })
}
12.3 diff算法
12.3.1 步骤
用 js 对象来描述 dom 树结构,然后用这个 js 对象来创建一棵真正的 dom 树,插入到文档中;当状态更新时,将新的 js 对象和旧的 js 对象进行比较,得到两个对象之间的差异;最后将差异应用到真正的 dom 上。
12.3.2 复杂度
12.3.2.1 树 diff 的时间复杂度 O(n^3)
两棵任意树之间求最小编辑距离(tree edit distance),需要把旧树的每个节点和新树的每个节点两两比较,这一步就是 O(n^2);再算出最小的增、删、改操作序列,整体是 O(n^3)。1000 个节点就是 10 亿次计算,前端完全不可用。
12.3.2.2 优化时间复杂度到 O(n)
基于两个前提做启发式简化:跨层级移动 DOM 很少见;不同类型的节点生成不同的树。
- 只比较同一层级,不跨级比较
- tag 不相同,则直接删掉重建,不再深度比较
- tag 与 key,两者都相同,则认为是相同节点,复用 DOM,再继续向下比较属性和子节点
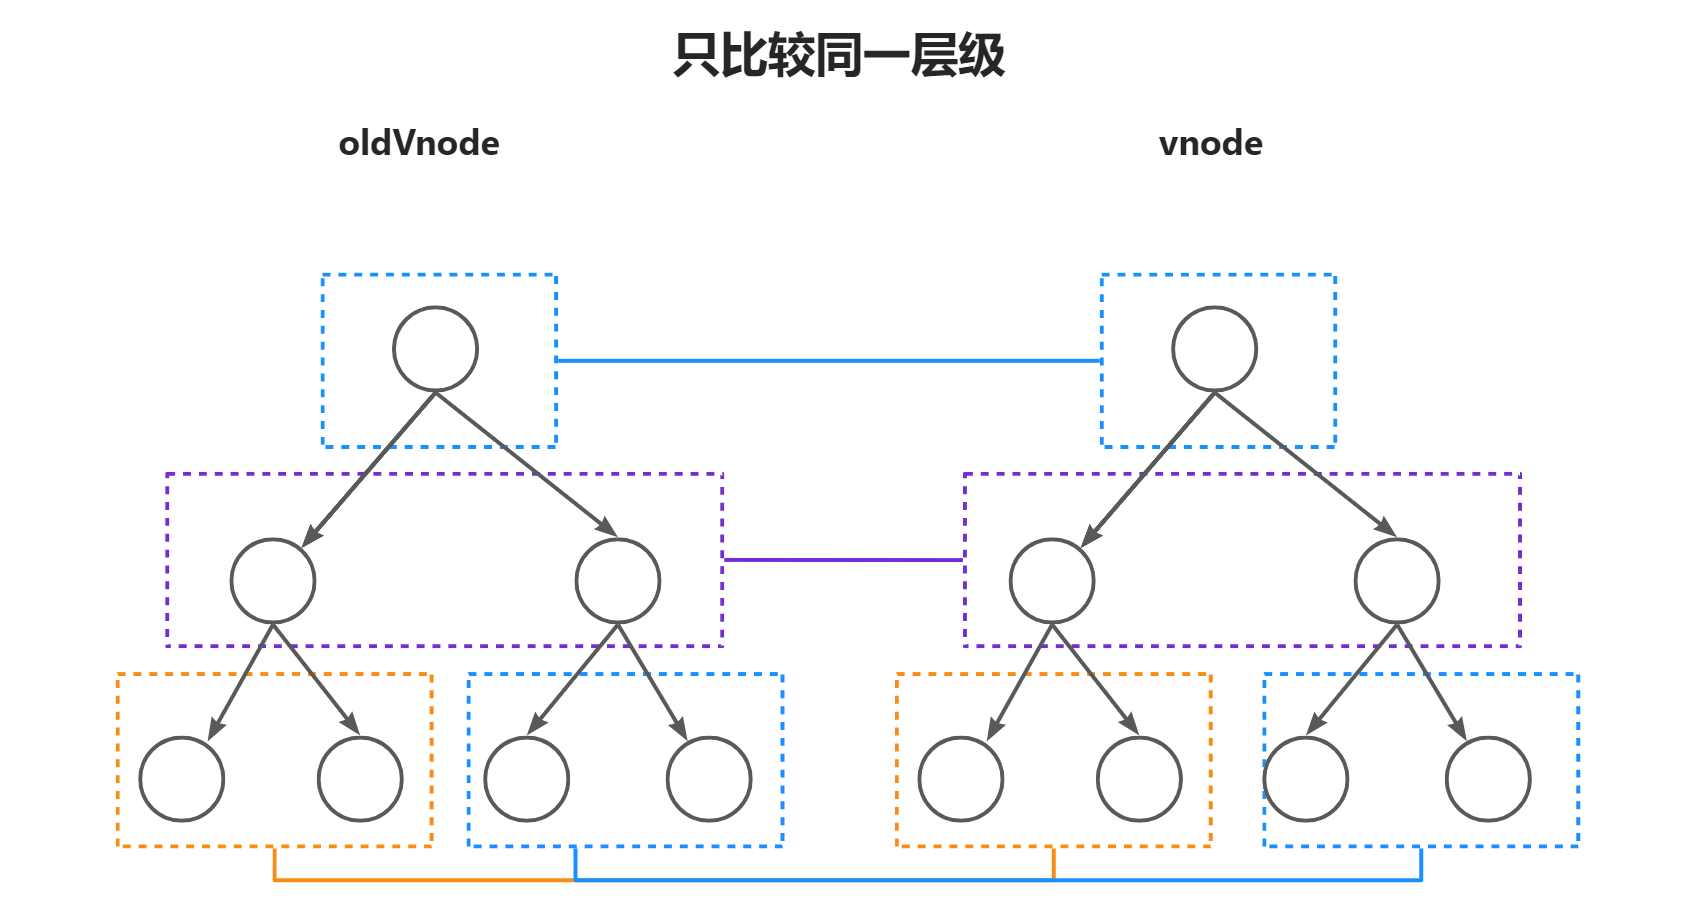
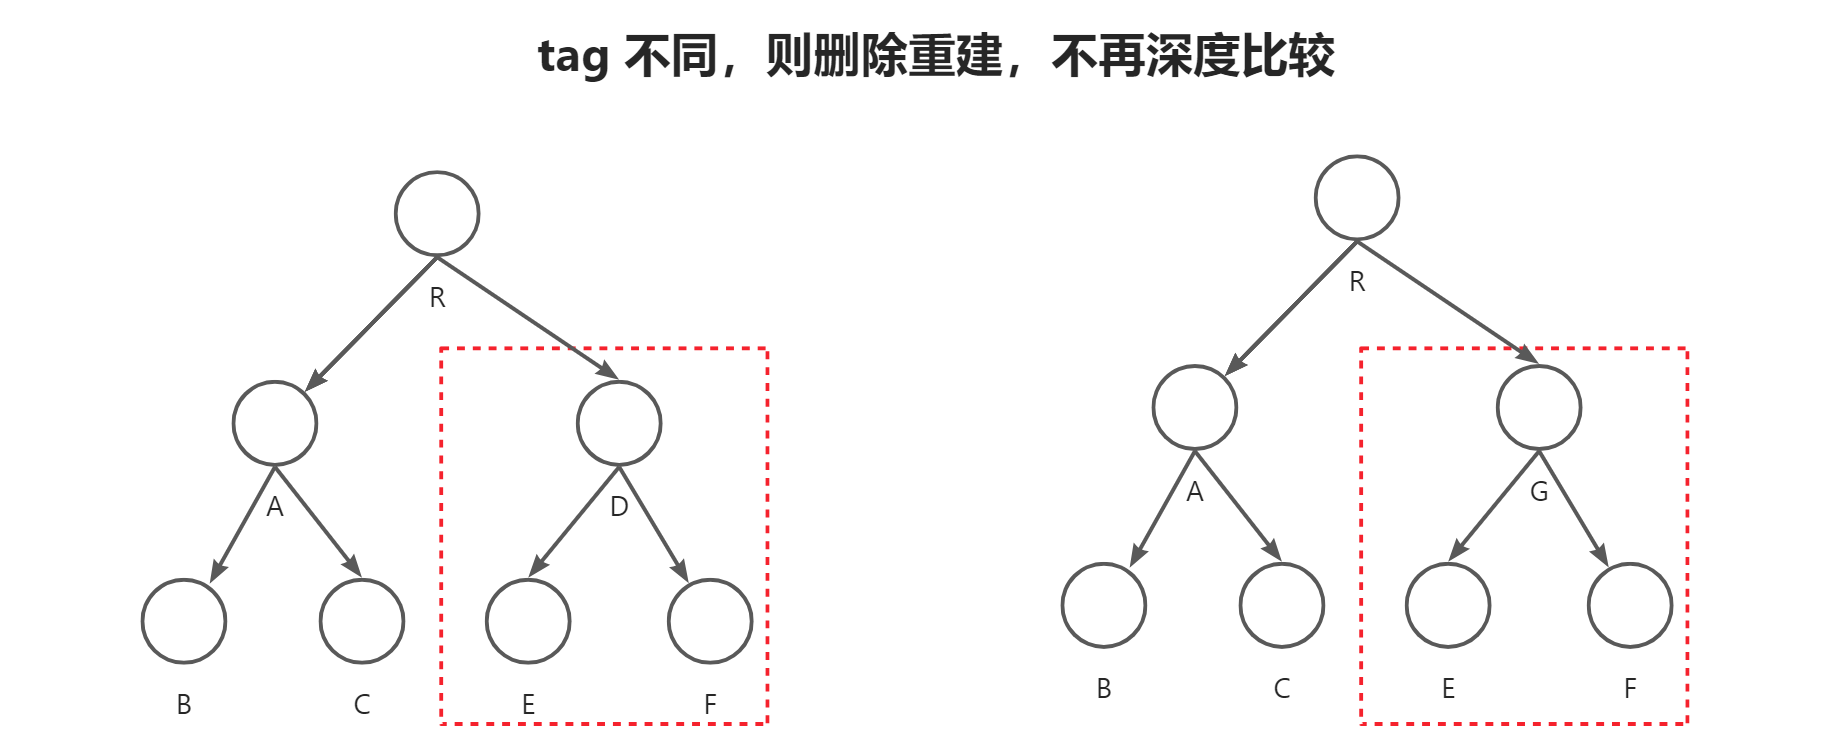
12.4 snabbdom源码分析
12.4.1 案例分析
import {
  init,
  classModule,
  propsModule,
  styleModule,
  eventListenersModule,
  h,
} from 'snabbdom'

const patch = init([
  // Init patch function with chosen modules
  classModule, // makes it easy to toggle classes
  propsModule, // for setting properties on DOM elements
  styleModule, // handles styling on elements with support for animations
  eventListenersModule, // attaches event listeners
])

const container = document.getElementById('container')

const vnode = h('div#container.two.classes', { on: { click: someFn } }, [
  h('span', { style: { fontWeight: 'bold' } }, 'This is bold'),
  ' and this is just normal text',
  h('a', { props: { href: '/foo' } }, "I'll take you places!"),
])
// Patch into empty DOM element – this modifies the DOM as a side effect
patch(container, vnode)

const newVnode = h('div#container.two.classes', { on: { click: anotherEventHandler } }, [
  h(
    'span',
    { style: { fontWeight: 'normal', fontStyle: 'italic' } },
    'This is now italic type'
  ),
  ' and this is still just normal text',
  h('a', { props: { href: '/bar' } }, "I'll take you places!"),
])
// Second `patch` invocation
patch(vnode, newVnode) // Snabbdom efficiently updates the old view to the new state
12.4.1.1 大白话解释
首先 snabbdom 模块提供一个 init 方法,调用 init 方法会返回一个 patch 函数,第一个参数 oldVNode 或 DOM,第二个参数是新的 VNode 节点,调用 patch 函数会对 DOM 进行更新。通过调用 h 函数来创建 VNode。初始化 patch(container, vnode),container作为应用根节点,更新patch(vnode, newVnode)。
12.4.1.2 hook 钩子
| Name | Triggered when | 触发时机 | Arguments to callback |
|---|---|---|---|
| pre | the patch process begins | patch 开始之前 | none |
| init | a vnode has been added | 已经创建了一个 vnode | vnode |
| create | a DOM element has been created based on a vnode | 已经基于 vnode 创建了一个 DOM,但尚未挂载 | emptyVnode, vnode |
| insert | an element has been inserted into the DOM | 创建的 DOM 被挂载了 | vnode |
| prepatch | an element is about to be patched | 一个元素即将被 patch | oldVnode, vnode |
| update | an element is being updated | 元素正在被更新 | oldVnode, vnode |
| postpatch | an element has been patched | 元素已经 patch 完毕 | oldVnode, vnode |
| destroy | an element is directly or indirectly being removed | 一个元素被直接或间接地移除了。间接移除的情况是指被移除元素的子元素 | vnode |
| remove | an element is directly being removed from the DOM | 一个元素被直接移除了(卸载) | vnode, removeCallback |
| post | the patch process is done | patch 结束 | none |
12.4.2 源码分析
源码注释版:https://github.com/wuchendi/Front-End/blob/master/12-snabbdom/3.0.1。这里只保留理解 diff 必需的部分,完整代码看仓库。
12.4.2.1 vnode
export interface VNode {
  sel: string | undefined // selector
  data: VNodeData | undefined
  children: Array<VNode | string> | undefined // 子节点
  elm: Node | undefined // element, 存储 HTMLELement
  text: string | undefined // 文本节点
  key: Key | undefined // 节点 key
}

export interface VNodeData {
  props?: Props // 节点属性
  attrs?: Attrs // 节点 attribute 属性
  class?: Classes // class 类名
  style?: VNodeStyle // style 样式
  dataset?: Dataset // html 自定义属性 data-
  on?: On // 事件
  attachData?: AttachData
  hook?: Hooks // 钩子
  key?: Key
  ns?: string // for SVGs
  fn?: () => VNode // for thunks
  args?: any[] // for thunks
  is?: string // for custom elements v1
  [key: string]: any // for any other 3rd party module
}
h 函数只负责创建 vnode:先格式化参数(h(sel)、h(sel, data)、h(sel, children)、h(sel, data, children) 几种重载),把字符串子节点转成文本 vnode,svg 元素补上命名空间,最后返回 vnode,并不会渲染到页面上。
12.4.2.2 sameVnode 函数
sameVnode 用来判断两个 vnode 是不是「同一个节点」,是的话复用 DOM 继续往下比较,不是就直接替换:
function sameVnode(vnode1: VNode, vnode2: VNode): boolean {
  // key 和 sel 都相等
  // 如果 key 没有传入 => undefined === undefined // true
  // 不传 key 情况分析:不在循环体里面,像直接定义的情况,直接通过 tag/sel 来比较
  const isSameKey = vnode1.key === vnode2.key
  const isSameIs = vnode1.data?.is === vnode2.data?.is
  const isSameSel = vnode1.sel === vnode2.sel

  return isSameSel && isSameKey && isSameIs
}
12.4.2.3 createElm 函数
createElm 函数的主要逻辑在于创建真实的 DOM 节点 vnode.elm。首先调用 init hook ,然后创建 DOM 树分为如下三种情形:
- vnode.sel === '!' 表示当前元素是注释节点,调用 createComment 创建注释节点,挂载到 vnode.elm;
- vnode.sel !== 'undefined',对当前选择器进行解析(tag、id,class等),调用 createElementNS 或 createElement 生成 elm,接着调用 create hook,如果存在 children,遍历所有子节点并递归调用 createElm 创建 dom,通过 appendChild 挂载到当前的 elm 上,不存在 children 但存在 text,便使用 createTextNode 来创建文本,再次调用 create hook 与 insert hook 存储起来等 dom 插入后才会调用,这里用个数组来保存能避免调用时再次对 vnode 树做遍历;
- 以上两种都不满足时,表示当前只是 text,调用 createTextNode 来创建文本,然后挂载到 vnode.elm;
flowchart TD
  A[createElm] --> B[调用 init hook]
  B --> C{vnode.sel}
  C -->|sel 为感叹号,注释节点| D[createComment 创建注释节点]
  C -->|有选择器| E[createElement 或 createElementNS 创建元素]
  C -->|没有选择器| L[createTextNode 创建文本节点]
  E --> F[解析选择器,设置 id 和 class]
  F --> G[调用 create hook]
  G --> H{children 还是 text}
  H -->|children| I[递归 createElm 创建子节点并 appendChild]
  H -->|text| J[createTextNode 创建文本子节点]
  I --> K[有 insert hook 时放进 insertedVnodeQueue,等 DOM 插入后统一调用]
  J --> K
  D --> M[返回 vnode.elm]
  K --> M
  L --> M
12.4.2.4 patchVnode 函数
patchVnode 函数的主要逻辑在于更新节点。首先调用 vnode 上的 prepatch hook,如果当前的两个 vnode 完全相同,直接返回。然后分如下两大类情形:
- vnode.text === undefined
- 新旧节点都存在 children,执行 updateChildren 更新
- 存在新 children,不存在旧 children,如果旧 text 存在,则先清空在调用 addVnodes 添加children
- 不存在新 children,存在旧 children,调用 removeVnodes 移除旧节点的 children
- oldVnode 存在 text,调用 setTextContent 置空
- vnode.text !== undefined,移除 oldVnode 对应的 dom 节点,并使用 setTextContent 更新 vnode.elm
flowchart TD
  A[patchVnode] --> B[调用 prepatch hook]
  B --> C{oldVnode === vnode}
  C -->|是| R[直接返回]
  C -->|否| D[调用 update hook]
  D --> E{新节点是文本节点吗}
  E -->|是,且文本不同| F[旧节点有 children 就 removeVnodes,再 setTextContent 更新文本]
  E -->|否| G{比较新旧 children}
  G -->|新旧都有| H[updateChildren]
  G -->|只有新的| I[清空旧文本,addVnodes 添加]
  G -->|只有旧的| J[removeVnodes 移除]
  G -->|都没有但旧节点有文本| K[setTextContent 置空]
  F --> P[调用 postpatch hook]
  H --> P
  I --> P
  J --> P
  K --> P
12.4.2.5 updateChildren 函数
updateChildren 是 diff 的核心,用于新旧两组子节点都存在时。它在新旧 children 上各放首、尾两个指针,每一轮按顺序尝试四种比较:
- 旧首 vs 新首:相同则 patch,两个首指针右移
- 旧尾 vs 新尾:相同则 patch,两个尾指针左移
- 旧首 vs 新尾:相同则 patch,并把旧首对应的 DOM 移到旧尾后面
- 旧尾 vs 新首:相同则 patch,并把旧尾对应的 DOM 移到旧首前面
四种都没命中,就用新首的 key 去旧 children 的 key → index 映射里找:找不到或 sel 不同就新建 DOM 插到旧首前;找到且 sel 相同就 patch 后把它移到旧首前,并把旧数组对应位置置空。循环到任一侧指针交叉为止:旧的先遍历完,就把新的剩余节点批量插入;新的先遍历完,就把旧的剩余节点批量删除。这就是常说的「双端比较」,对头尾插入、反转这类常见操作很高效。
flowchart TD
  S[新旧 children 各放首尾两个指针] --> L{两侧指针都没有交叉}
  L -->|否| End{哪一侧先遍历完}
  End -->|旧的先完| Add[批量插入新的剩余节点]
  End -->|新的先完| Del[批量删除旧的剩余节点]
  L -->|是| C1{旧首 vs 新首}
  C1 -->|相同| P1[patch,两个首指针右移] --> L
  C1 -->|不同| C2{旧尾 vs 新尾}
  C2 -->|相同| P2[patch,两个尾指针左移] --> L
  C2 -->|不同| C3{旧首 vs 新尾}
  C3 -->|相同| P3[patch,旧首 DOM 移到旧尾后面] --> L
  C3 -->|不同| C4{旧尾 vs 新首}
  C4 -->|相同| P4[patch,旧尾 DOM 移到旧首前面] --> L
  C4 -->|不同| K{用 key 在旧 children 里找}
  K -->|找到且 sel 相同| M[patch 后移到旧首前面] --> L
  K -->|找不到或 sel 不同| N[新建 DOM 插到旧首前面] --> L
function updateChildren(
parentElm: Node,
oldCh: VNode[],
newCh: VNode[],
insertedVnodeQueue: VNodeQueue
) {
let oldStartIdx = 0
let newStartIdx = 0
let oldEndIdx = oldCh.length - 1
let oldStartVnode = oldCh[0]
let oldEndVnode = oldCh[oldEndIdx]
let newEndIdx = newCh.length - 1
let newStartVnode = newCh[0]
let newEndVnode = newCh[newEndIdx]
let oldKeyToIdx: KeyToIndexMap | undefined
let idxInOld: number
let elmToMove: VNode
let before: any
// 遍历 oldCh newCh,对节点进行比较和更新
// 每轮比较最多处理一个节点,算法复杂度 O(n)
while (oldStartIdx <= oldEndIdx && newStartIdx <= newEndIdx) {
if (oldStartVnode == null) {
oldStartVnode = oldCh[++oldStartIdx] // Vnode might have been moved left
} else if (oldEndVnode == null) {
oldEndVnode = oldCh[--oldEndIdx]
} else if (newStartVnode == null) {
newStartVnode = newCh[++newStartIdx]
} else if (newEndVnode == null) {
newEndVnode = newCh[--newEndIdx]
}
// 以旧 vnode 首节点和新 vnode 首节点对比
else if (sameVnode(oldStartVnode, newStartVnode)) {
patchVnode(oldStartVnode, newStartVnode, insertedVnodeQueue)
oldStartVnode = oldCh[++oldStartIdx]
newStartVnode = newCh[++newStartIdx]
}
// 以旧 vnode 尾节点和新 vnode 尾节点对比
else if (sameVnode(oldEndVnode, newEndVnode)) {
patchVnode(oldEndVnode, newEndVnode, insertedVnodeQueue)
oldEndVnode = oldCh[--oldEndIdx]
newEndVnode = newCh[--newEndIdx]
}
// 以旧 vnode 首节点和新 vnode 尾节点对比
else if (sameVnode(oldStartVnode, newEndVnode)) {
// Vnode moved right
patchVnode(oldStartVnode, newEndVnode, insertedVnodeQueue)
api.insertBefore(parentElm, oldStartVnode.elm!, api.nextSibling(oldEndVnode.elm!))
oldStartVnode = oldCh[++oldStartIdx]
newEndVnode = newCh[--newEndIdx]
}
// 以旧 vnode 尾节点和新 vnode 新节点对比
else if (sameVnode(oldEndVnode, newStartVnode)) {
// Vnode moved left
patchVnode(oldEndVnode, newStartVnode, insertedVnodeQueue)
api.insertBefore(parentElm, oldEndVnode.elm!, oldStartVnode.elm!)
oldEndVnode = oldCh[--oldEndIdx]
newStartVnode = newCh[++newStartIdx]
}
// 以上4中都未命中
else {
if (oldKeyToIdx === undefined) {
oldKeyToIdx = createKeyToOldIdx(oldCh, oldStartIdx, oldEndIdx)
}
// 拿新节点 key , 能否对应上 oldCh 中的某个节点的 key
idxInOld = oldKeyToIdx[newStartVnode.key as string]
// 对应不上
if (isUndef(idxInOld)) {
// New element
api.insertBefore(
parentElm,
createElm(newStartVnode, insertedVnodeQueue),
oldStartVnode.elm!
)
}
// 对应上了
else {
// 拿到对应上 key 的节点
elmToMove = oldCh[idxInOld]
// sel 是否相等(sameVnode 条件)
// sel 不相等,key相等
if (elmToMove.sel !== newStartVnode.sel) {
// New element
api.insertBefore(
parentElm,
createElm(newStartVnode, insertedVnodeQueue),
oldStartVnode.elm!
)
}
// sel 相等,key 相等
else {
patchVnode(elmToMove, newStartVnode, insertedVnodeQueue)
oldCh[idxInOld] = undefined as any
api.insertBefore(parentElm, elmToMove.elm!, oldStartVnode.elm!)
}
}
// 更新之后,调整指针
newStartVnode = newCh[++newStartIdx]
}
}
// oldCh 已经全部处理完成,而 newCh 还有新的节点,需要对剩下的每个项都创建新的 dom
if (oldStartIdx <= oldEndIdx || newStartIdx <= newEndIdx) {
if (oldStartIdx > oldEndIdx) {
before = newCh[newEndIdx + 1] == null ? null : newCh[newEndIdx + 1].elm
addVnodes(parentElm, before, newCh, newStartIdx, newEndIdx, insertedVnodeQueue)
} else {
// newCh 已经全部处理完成,而 oldCh 还有旧的节点,需要将多余的节点移除
removeVnodes(parentElm, oldCh, oldStartIdx, oldEndIdx)
}
}
}12.5 diff 过程
- patch
- patchVnode
- addVnode
- removeVnode
- updateChildren
- diff算法极致的性能优化做出的改变
12.6 vnode.key的作用是什么?
key 是用来判断两个 VNode 是否相同,参与到 diff 过程的一些判断中。key 情况分如下两种情况:
- 当 key 相同时,调用 patchVnode 函数 更新节点,首先在旧列表中找到对应的 DOM 节点,然后执行移动操作;
- 当 key 不相同时,会调用 createElm 函数 创建新节点,然后如果存在父节点,便将其插入到 dom 上,然后移除旧的 dom 节点来完成更新;
换句话说,key 用来在一个兄弟节点列表中进行唯一标记,这样在构建新节点的时候,会根据 key 去查找已经存在的节点,而不是就地复用,同时移除 key 不存在的节点。
为什么不建议用数组下标当 key:在列表头部插入或删除、排序时,下标会整体错位,框架会把「内容不同的节点」当成同一个去复用。轻则多出不必要的 DOM 更新,重则带内部状态的组件(输入框内容、勾选状态)对应错行。key 要用稳定、唯一的业务 id;列表只追加、不重排、没有状态时用下标才没问题。
12.7 Vue 与 React实现对比
Vue v2 中的 patch 机制就是基于 snabbdom 类库改造实现的。Vue 3 重写了渲染器,没有切到 infernojs,只是在子节点 diff 中借鉴了 inferno / ivi 的最长递增子序列思路,同时加入了编译期优化。 React v16+ 在推行 Fiber 之后,摒弃了递归 diff 的做法,把渲染拆成可中断的工作单元,但 diff 的核心思想是类似的。
12.8 Vue2和Vue3和React三者的diff算法有什么区别
- Vue2:双端比较(就是上面 snabbdom 的 updateChildren)
- Vue3:先掐头去尾比较相同的前缀和后缀,剩下的乱序部分用最长递增子序列(LIS)求出不需要移动的节点,只移动其余节点,DOM 移动次数最少。再配合编译器生成的 PatchFlags、Block Tree 和静态提升,运行时只比较动态节点
- React:单链表结构没法双端遍历,只从左往右一遍。用
lastPlacedIndex记录最后一个不需要移动的旧节点位置,旧位置比它小的节点就往右移(所以说「仅右移」)。把最后一个节点挪到最前面时,React 会移动前面所有节点,而 Vue 只需移动一次
虚拟 DOM 不再是唯一答案:Svelte 5(runes)、SolidJS 用编译 + Signals 直接定位到需要更新的 DOM;Vue 也在推进不使用虚拟 DOM 的 Vapor Mode;Angular 引入了 Signals。React 这边仍是虚拟 DOM,但 React Compiler(2025 年发布 1.0)在编译期自动做 memo,减少无效的重新渲染。面试被问「虚拟 DOM 一定比直接操作 DOM 快吗」,答案是否定的:它的价值是在声明式开发和可接受的性能之间取平衡,并带来跨平台能力(React Native、小程序、Canvas 渲染等)。
十三、框架与元框架
虚拟 DOM 和 diff 算法见上一章,这里讲框架层面的原理和选型。本章的 React 示例都用 React 19.3 的类型定义检查过,响应式和 Signals 的迷你实现都在 Node 里跑过。
13.1 React
13.1.1 Fiber 与调度
React 16 之前,更新是从根节点开始递归 diff 整棵树,一旦开始就不能中断,组件树很大时会长时间占用主线程,造成卡顿。Fiber 架构做了两件事:
- 把渲染拆成小的工作单元:每个组件对应一个 Fiber 节点,节点之间用
child、sibling、return指针连成链表,遍历可以随时暂停,之后从断点继续。 - 按优先级调度:用 lanes 模型给更新分优先级。用户输入是最高优先级,数据加载、列表过滤这类更新可以被打断、延后。调度器以大约 5ms 为一个时间片执行工作,时间用完就让出主线程。
一次更新分两个阶段:
- render 阶段:调用组件函数、diff 出变化,构建新的 Fiber 树。这个阶段可中断、可能执行多次,所以组件函数必须是纯函数,不能有副作用(这也是开发环境下 StrictMode 会故意调用两次的原因)。
- commit 阶段:把变化同步应用到 DOM,然后执行
useLayoutEffect,之后异步执行useEffect。这个阶段不可中断。
13.1.2 Hooks 原理
每个组件的 Hooks 按调用顺序存在对应 Fiber 节点的一个链表上,每次渲染按同样的顺序逐个读取。所以 Hooks 不能写在条件、循环里:调用顺序一变,状态就对不上了。
最常考的坑是过期闭包:组件每次渲染都是一次独立的函数调用,回调捕获的是那一次渲染的 state。
// 1. 过期闭包:定时器回调永远读到第一次渲染时的 count
function Counter() {
  const [count, setCount] = useState(0)
  useEffect(() => {
    const id = setInterval(() => {
      setCount(count + 1) // ❌ count 永远是 0,页面停在 1
    }, 1000)
    return () => clearInterval(id)
  }, []) // 依赖数组漏了 count
  return <p>{count}</p>
}

// 修复:用函数式更新,不依赖闭包里的值
function CounterFixed() {
  const [count, setCount] = useState(0)
  useEffect(() => {
    const id = setInterval(() => setCount((c) => c + 1), 1000)
    return () => clearInterval(id)
  }, [])
  return <p>{count}</p>
}

// 需要在 effect 里读最新值、又不想让它触发 effect 重跑时,用 useEffectEvent(React 19.2)
function Chat({ roomId, theme }: { roomId: string; theme: string }) {
  const onConnected = useEffectEvent(() => {
    console.log(`connected to ${roomId}, theme: ${theme}`) // 总能读到最新的 theme
  })
  useEffect(() => {
    const timer = setTimeout(onConnected, 100) // 模拟连接成功
    return () => clearTimeout(timer)
  }, [roomId]) // 只有 roomId 变化才重连,theme 变化不会
  return null
}
13.1.3 并发特性
React 18 起提供并发特性,核心是把更新分成紧急和非紧急两类:
useTransition:把某个状态更新标记为非紧急(比如切换标签页后渲染一个很重的列表),期间用户输入能打断它,isPending可以用来显示加载状态。useDeferredValue:得到一个「延后」版本的值,输入框用原值立即响应,耗时的搜索结果列表用延后值渲染。Suspense:声明组件在等待数据或代码时显示什么,配合流式 SSR 可以让页面先发出已经准备好的部分。- 自动批处理:React 18 起,
setTimeout、Promise 回调里的多次setState也会合并成一次渲染(以前只有事件处理函数里会合并)。
13.1.4 React 19
React 19 的主线是 Actions:把「异步提交 + pending 状态 + 错误处理 + 乐观更新」统一起来,不再需要手写一堆 isLoading、error 状态。
// 2. Actions:表单提交、pending 状态、错误处理一起管理
function NameForm({ currentName }: { currentName: string }) {
  const [optimisticName, setOptimisticName] = useOptimistic(currentName)
  const [error, submitAction, isPending] = useActionState(
    async (_prev: string | null, formData: FormData) => {
      const name = String(formData.get('name'))
      setOptimisticName(name) // 请求返回前先展示新值,失败会自动回滚
      const result = await updateName(name)
      return result.error ?? null
    },
    null,
  )
  return (
    <form action={submitAction}>
      <p>当前名字:{optimisticName}</p>
      <input name="name" />
      <button type="submit" disabled={isPending}>
        {isPending ? '保存中…' : '保存'}
      </button>
      {error && <p>{error}</p>}
    </form>
  )
}
其他变化:
// 3. use:在渲染中读取 Promise(配合 Suspense),也可以在条件语句里读取 Context
function Comments({ commentsPromise }: { commentsPromise: Promise<string[]> }) {
  const comments = use(commentsPromise) // Promise pending 时挂起,由外层 Suspense 显示 fallback
  return <ul>{comments.map((c) => <li key={c}>{c}</li>)}</ul>
}ref可以直接作为 prop 传给函数组件,不再需要forwardRef;ref 回调可以返回清理函数。- 组件里直接渲染
<title>、<meta>、<link>,React 会把它们提升到<head>。 <form action={fn}>原生支持传函数,useFormStatus可以在子组件里读取所在表单的提交状态。- React 19.2 新增了
<Activity>:隐藏的部分保留状态但暂停 effect,适合标签页、预渲染下一屏。
13.1.5 Server Components 与 Server Actions
Server Components(RSC)只在服务端(或构建时)运行:
- 可以直接
await数据库、读文件,不需要再写一层 API; - 组件代码和它用到的依赖(比如 Markdown 解析库)不会打包进客户端 JS;
- 输出的是一种序列化的组件树(RSC payload),客户端拿到后和客户端组件拼起来渲染。
需要状态、事件、浏览器 API 的组件,在文件顶部写 'use client' 标记为客户端组件。边界规则是面试重点:
flowchart TD
  S1[服务端组件:页面] --> S2[服务端组件:文章内容,直接查数据库]
  S1 --> C1[客户端组件:点赞按钮,use client]
  C1 -->|通过 children 传入| S3[服务端组件也能作为 children 渲染在客户端组件里]
C1 -.->|不能直接 import| S4[服务端组件]- 服务端组件可以渲染客户端组件,传给客户端组件的 props 必须可以序列化(不能传函数,Server Action 除外);
- 客户端组件不能直接 import 服务端组件,但可以通过
children等 prop 接收已经渲染好的服务端组件; 'use client'标记的是一个边界:这个文件和它导入的所有模块都会进入客户端 bundle,所以边界要尽量往叶子节点放。
Server Actions('use server')是可以在客户端直接调用的服务端函数,框架会自动把调用变成一次 POST 请求。它本质上就是一个公开的 HTTP 接口,必须在函数内部做鉴权和参数校验,不能因为「只在自己的表单里调用」就省略。
// app/actions.ts
'use server'

export async function addComment(formData: FormData) {
  const session = await auth() // 每个 Server Action 都要自己鉴权
  if (!session) throw new Error('Unauthorized')
  const content = z.string().min(1).max(500).parse(formData.get('content'))
  await db.comment.create({ data: { content, userId: session.userId } })
  revalidatePath('/posts') // 让相关页面的缓存失效
}
13.1.6 React Compiler
React Compiler 在 2025 年发布 1.0。它在构建时分析组件,自动插入等价于 useMemo、useCallback、React.memo 的缓存逻辑,并且粒度比手写更细。影响:
- 大部分手写的 memo 可以删掉,代码更简洁;
- 前提是代码遵守 React 的规则(组件和 Hooks 是纯的、不直接修改 props 和 state),不符合规则的组件编译器会跳过;
- 面试时被问「怎么避免不必要的重新渲染」,现在的答案是:先保证组件纯净、状态放在正确的位置(就近、拆分 Context),再交给编译器,最后才考虑手写 memo。
13.2 Vue
13.2.1 响应式原理
- Vue 2 用
Object.defineProperty劫持每个属性的 getter / setter。初始化时要递归遍历整个对象;新增、删除属性和通过下标修改数组检测不到,需要Vue.set;数组方法是通过改写原型实现的。 - Vue 3 用
Proxy代理整个对象,能拦截新增、删除属性和数组下标;只有访问到嵌套对象时才代理(惰性),初始化更快、内存更省。
依赖收集的核心结构是 target → key → effects,下面是一个能跑的极简实现:
// 极简版 Vue 3 响应式:reactive + effect,依赖结构是 target -> key -> effects
const targetMap = new WeakMap()
let activeEffect = null

function track(target, key) {
  if (!activeEffect) return
  let depsMap = targetMap.get(target)
  if (!depsMap) targetMap.set(target, (depsMap = new Map()))
  let deps = depsMap.get(key)
  if (!deps) depsMap.set(key, (deps = new Set()))
  deps.add(activeEffect)
}

function trigger(target, key) {
  targetMap.get(target)?.get(key)?.forEach((effect) => effect())
}

function reactive(obj) {
  return new Proxy(obj, {
    get(target, key, receiver) {
      track(target, key) // 读取时收集依赖
      const value = Reflect.get(target, key, receiver)
      // 访问到嵌套对象时才代理(惰性),Vue 2 是初始化时递归遍历
      return value !== null && typeof value === 'object' ? reactive(value) : value
    },
    set(target, key, value, receiver) {
      const result = Reflect.set(target, key, value, receiver)
      trigger(target, key) // 修改时通知
      return result
    },
  })
}

function effect(fn) {
  const run = () => {
    activeEffect = run
    try {
      fn()
    } finally {
      activeEffect = null
    }
  }
  run()
}

const state = reactive({ count: 0, user: { name: 'wudi' } })
effect(() => console.log('count is', state.count)) // count is 0
effect(() => console.log('name is', state.user.name)) // name is wudi
state.count++ // count is 1
state.user.name = 'cdd' // name is cdd
state.newKey = 1 // 新增属性也能拦截,Vue 2 的 defineProperty 做不到
ref 是为原始值准备的:Proxy 只能代理对象,所以 ref 用一个带 value 访问器的对象把值包起来,这也是在 JS 里使用 ref 要写 .value 的原因(模板里会自动解包)。computed 是带缓存的 effect:依赖不变时直接返回上次的结果,依赖变化时才标记为脏、下次读取时重新计算。
13.2.2 双向绑定与 v-model
双向绑定 = 响应式(数据 → 视图)+ 事件监听(视图 → 数据)。v-model 是语法糖:
- 在原生 input 上等价于
:value="msg" @input="msg = $event.target.value"(不同的表单元素监听的事件不同); - 在组件上,Vue 3 等价于
:modelValue="msg" @update:modelValue="msg = $event",支持多个v-model:xxx; - Vue 3.4 起子组件可以用
defineModel()直接拿到一个可读写的 ref,不用再手写 props + emit。
13.2.3 编译期优化
Vue 的模板是静态可分析的,编译器能提前知道哪些部分会变,这是它和 JSX 的关键区别:
- PatchFlags:给动态节点打标记(只有文本动态、只有 class 动态……),运行时只比较被标记的部分;
- Block Tree:把动态节点收集到所在 block 的一个扁平数组里,更新时直接遍历这个数组,跳过所有静态节点,不用逐层 diff;
- 静态提升:完全静态的节点只创建一次,后续渲染直接复用;
- 事件缓存:内联的事件处理函数被缓存,不会因为每次渲染生成新函数而导致子组件更新。
13.2.4 Vapor Mode
Vapor Mode 是 Vue 的一种新编译模式:组件不再生成虚拟 DOM,而是直接编译成精确的 DOM 操作,配合响应式系统做细粒度更新,思路和 SolidJS 接近。它可以按组件开启,和普通组件混用,适合性能敏感的部分。
13.2.5 状态管理
Pinia 是 Vue 官方的状态管理库,取代了 Vuex:没有 mutations,直接在 action 里修改 state;基于组合式 API,TypeScript 类型推导完整;支持 DevTools 和 SSR。简单场景不需要任何状态库,写一个返回 ref 的 composable,在多个组件中共享即可(SSR 下要注意模块级状态会在请求之间共享)。
13.3 Signals 与非虚拟 DOM 路线
虚拟 DOM 的更新模型是「状态变了 → 重新执行组件函数 → diff 新旧虚拟 DOM → 更新真实 DOM」。Signals 的思路不同:每个状态单独追踪谁用到了它,变化时只执行那些依赖它的更新函数,组件函数本身只执行一次。
// 极简版 Signals:signal 存值,effect 自动追踪用到的 signal
let currentEffect = null

function signal(value) {
  const subscribers = new Set()
  const read = () => {
    if (currentEffect) subscribers.add(currentEffect)
    return value
  }
  const write = (next) => {
    if (Object.is(next, value)) return
    value = next
    subscribers.forEach((fn) => fn())
  }
  return [read, write]
}

function effect(fn) {
  const run = () => {
    currentEffect = run
    fn()
    currentEffect = null
  }
  run()
}

function computed(fn) {
  const [get, set] = signal()
  effect(() => set(fn()))
  return get
}

const [count, setCount] = signal(1)
const double = computed(() => count() * 2)
// 真实框架里,这个 effect 就是「更新某一个文本节点」,组件函数本身不会重新执行
effect(() => console.log('double =', double())) // double = 2
setCount(5) // double = 10
setCount(5) // 值没变,不触发
SolidJS、Svelte 5 的 runes($state、$derived)、Vue 的 ref、Angular Signals、Preact Signals 本质上都是这个模型,TC39 也有一个 Signals 提案在推进。
什么时候不需要虚拟 DOM:
- 适合 Signals:更新频繁、粒度很细的界面,比如大表格、实时行情、编辑器、可视化。只更新变化的那个节点,没有 diff 开销,内存占用也小。
- 虚拟 DOM 的优势:「UI = f(state)」的心智模型简单,组件就是普通函数;生态成熟;同一套组件可以渲染到 DOM 以外的目标(React Native、Canvas、终端)。React 选择用编译器(React Compiler)弥补性能差距,而不是放弃虚拟 DOM。
13.4 元框架
13.4.1 渲染方式
| 方式 | 说明 | 适用 |
|---|---|---|
| CSR | 浏览器下载 JS 后渲染 | 后台管理系统、不需要 SEO 的应用 |
| SSR | 每次请求在服务端渲染 HTML,客户端再 hydrate | 个性化、实时数据的页面 |
| SSG | 构建时生成 HTML | 博客、文档、营销页 |
| ISR | SSG + 按时间或按需在后台重新生成 | 内容会更新但不要求实时的页面 |
| 流式 SSR | HTML 分块发送,先发外壳,慢的部分用 Suspense 包起来稍后补上 | 首屏需要快,部分数据又较慢的页面 |
| Islands | 页面默认是静态 HTML,只有交互组件(岛屿)加载 JS 并 hydrate | 内容为主、少量交互的站点 |
Hydration(注水) 是 SSR 的关键成本:服务端返回的 HTML 虽然能看,但要等客户端下载并执行完 JS、给 DOM 绑上事件后才能交互。RSC、Islands、Qwik 的 resumability 都是在想办法减少需要 hydrate 的 JS。
13.4.2 主流元框架
| 定位 | 特点 | |
|---|---|---|
| Next.js | React 全栈框架 | App Router 基于 RSC;Next 16 用 Cache Components('use cache')显式声明缓存,默认使用 Turbopack |
| Nuxt | Vue 全栈框架 | 按路由配置渲染规则(SSR / SSG / ISR 混用),基于 Nitro 服务端引擎,可以部署到各种平台 |
| React Router 7(原 Remix) | React,贴近 Web 标准 | loader / action 数据流,表单渐进增强;既能做 SPA 也能做全栈 |
| Astro | 内容站 | 默认零 JS,Islands 架构,可以混用 React、Vue、Svelte 组件 |
| SvelteKit | Svelte 全栈框架 | 编译器生成的产物小 |
选型思路:
- 内容为主(博客、文档、营销页):Astro 或任意框架的 SSG;
- 强交互、需要 SEO 的应用:Next.js(React)或 Nuxt(Vue);
- 后台管理系统等内部工具:Vite + SPA 就够了,上 SSR 只会增加复杂度;
- 团队已有技术栈的影响往往大于框架本身的差异。
13.4.3 Next.js App Router 常问点
- 服务端组件和客户端组件的边界:见 Server Components 与 Server Actions。
- 缓存:Next 15 起
fetch默认不再缓存;Next 16 的 Cache Components 用'use cache'显式标记哪些组件、函数的结果可以缓存,再用cacheLife设置有效期、cacheTag+revalidateTag按需失效。核心思想是缓存要显式声明,而不是靠框架猜。 - 数据获取:在服务端组件里直接
await;并行的请求用Promise.all发起,避免串行瀑布;慢的部分用Suspense包起来流式输出。 - Middleware / Proxy:在请求到达页面之前运行(鉴权、重定向、国际化),通常部署在边缘。
13.5 状态与数据层
13.5.1 客户端状态和服务端状态要分开
很多项目的状态管理之所以复杂,是因为把两类本质不同的状态混在了一起:
- 服务端状态:接口数据。它本质是远端数据在本地的缓存,需要处理的问题是请求去重、缓存失效、后台刷新、分页、乐观更新、窗口重新聚焦时更新……这些交给 TanStack Query 或 SWR。
- 客户端状态:UI 状态(弹窗开关、当前选中项、表单草稿)。数量通常很少,
useState/ Context / 轻量状态库就够了。
// TanStack Query:请求、缓存、loading、错误都由它管理
const { data, isPending, error } = useQuery({
  queryKey: ['todos', filter], // key 变化会自动重新请求,相同 key 的请求会去重
  queryFn: () => fetchTodos(filter),
  staleTime: 60_000, // 1 分钟内认为数据是新鲜的,不重复请求
})

const queryClient = useQueryClient()
const addTodo = useMutation({
  mutationFn: createTodo,
  // 成功后让列表缓存失效,自动重新获取
  onSuccess: () => queryClient.invalidateQueries({ queryKey: ['todos'] }),
})
13.5.2 客户端状态库
| 库 | 模型 | 适用 |
|---|---|---|
| Redux Toolkit | 单一 store + reducer,不可变更新 | 大型团队、需要严格的数据流和时间旅行调试 |
| Zustand | 极简 store + selector 订阅 | 大多数中小型应用的首选 |
| Jotai | 原子化状态,组件按需订阅单个 atom | 状态之间依赖多、需要细粒度更新 |
| Valtio | 基于 Proxy,直接修改对象 | 习惯可变写法的团队 |
import { create } from 'zustand'

const useCartStore = create<{ items: string[]; add: (id: string) => void }>((set) => ({
  items: [],
  add: (id) => set((state) => ({ items: [...state.items, id] })),
}))

// 组件只订阅自己用到的那部分,items 以外的状态变化不会触发它重新渲染
const count = useCartStore((state) => state.items.length)
Context 不是状态管理工具,而是依赖注入:Provider 的 value 一变,所有消费它的组件都会重新渲染。适合放变化不频繁的东西(主题、当前用户、语言),频繁变化的状态放进 Context 会导致大面积重新渲染。
13.5.3 端到端类型安全
前后端都用 TypeScript 时,接口类型最好只定义一次:
- tRPC:后端定义 procedure,前端直接导入它的类型,调用时有完整的参数和返回值提示,不需要生成代码;适合同一个 monorepo 里的全栈项目。
- Server Actions:Next.js 里直接调用服务端函数,类型天然一致。
- OpenAPI:后端是其他语言时,从 OpenAPI 文档生成前端的类型和请求函数(openapi-typescript 等)。
- GraphQL:从 schema 和查询语句生成类型(GraphQL Code Generator)。现在它更多用在数据来源多、客户端种类多(Web、App、第三方)的大型系统里,一般的 TS 全栈项目更倾向于前两种更轻的方案。
13.5.4 GraphQL
- 一次请求拿到页面需要的所有数据,减少 REST 多个接口串行请求的往返次数
- 客户端精确声明字段,避免返回多余数据(over-fetching),也避免数据不够还要再请求(under-fetching)
- 服务端用 DataLoader 批量合并、缓存数据库查询,解决 N+1 问题
- 用持久化查询(persisted queries)把长查询换成 hash,减小请求体积,还能走 GET 被 CDN 缓存
- 客户端(Apollo、urql、Relay)用规范化缓存,相同实体不重复请求
GraphQL能够根据页面展示需求请求所需要的数据,不会有冗余的数据,传输效率上会更高
但它不是银弹:所有请求都是 POST 到同一个端点,HTTP 缓存和 CDN 缓存很难直接用;查询过深、过复杂时会拖垮服务端,需要做深度和复杂度限制。现在 TypeScript 全栈项目里,tRPC 或直接用 Server Actions 也是常见的替代选择。
13.6 常见问题速答
- React 和 Vue 的核心区别? 更新粒度:Vue 的响应式能精确知道哪个组件依赖哪个数据,更新只发生在相关组件;React 默认状态变化后重新渲染整个子树,再靠 diff、memo(现在是编译器)减少开销。写法上,React 是 JSX + 函数式,Vue 是模板 + 编译优化。
- 为什么 React 不用响应式? React 坚持不可变数据和「渲染是纯函数」的模型,便于实现可中断的并发渲染和时间切片;代价是需要额外的手段避免无效渲染。
useEffect和useLayoutEffect的区别? 前者在浏览器绘制之后异步执行;后者在 DOM 更新后、绘制前同步执行,适合需要读取布局并立即修改、避免闪烁的场景,滥用会阻塞绘制。- key 的作用? 见 vnode.key的作用是什么?。
- SSR 的 hydration mismatch 是怎么回事? 服务端和客户端第一次渲染的结果不一致(用了
Date.now()、Math.random()、window、浏览器扩展修改了 DOM 等)。解决方法是保证首屏渲染只依赖服务端也能拿到的数据,浏览器专属的逻辑放进 effect。
十四、HTTP 协议
- HTTP 协议的主要特点
- HTTP 报文的组成部分
- HTTP 方法
- POST 和 GET 的区别
- HTTP 状态码
- 什么是持久连接
- 什么是管线化
- HTTP 与 HTTPS
14.1 HTTP 协议的主要特点
- 简单快速:请求只需要方法和路径,报文是可读的文本(HTTP/2 起改为二进制分帧)
- 灵活:可以传输任意类型的数据,用
Content-Type标识 - 无状态:协议本身不记录之前的请求,会话状态要靠 Cookie、Token 等机制维持
- 可扩展:通过新增头部字段扩展能力,比如缓存、CORS、压缩
很多老资料还会列一条「无连接」,指的是 HTTP/1.0 每个请求完成后就断开连接。HTTP/1.1 起默认持久连接,这一条已经不成立,见下文 14.6 持久连接。
14.2 HTTP 报文的组成部分
flowchart TD
  Q[请求报文] --> Q1[请求行] & Q2[请求头] & Q3[空行] & Q4[请求体]
  R[响应报文] --> R1[状态行] & R2[响应头] & R3[空行] & R4[响应体]
POST /api/login HTTP/1.1
Host: example.com
Content-Type: application/json
{"user": "wudi"}第一行是请求行(方法、路径、协议版本),接着是请求头,一个空行之后是请求体。响应报文结构一样,第一行换成状态行,比如 HTTP/1.1 200 OK。
14.3 HTTP 方法
* GET             获取资源
* POST            传输资源
* PUT             更新资源(整体替换)
* PATCH           更新资源(部分修改)
* DELETE          删除资源
* HEAD            获得报文首部
* OPTIONS         查询服务器支持的方法,CORS 预检请求用的就是它
GET、HEAD、OPTIONS 是安全的(不修改资源);GET、HEAD、PUT、DELETE、OPTIONS 是幂等的(执行多次和一次效果相同);POST、PATCH 既不安全也不幂等。
14.4 POST 和 GET 的区别(1、3、5、6、8)
* GET在浏览器回退时是无害的,而POST会再次提交请求
* GET产生的URL地址可以被收藏,而POST不可以
* GET请求会被浏览器主动缓存,而POST不会,除非手动设置
* GET请求只能进行url编码,而POST支持多种编码方式
* GET请求参数会被完整保留在浏览器历史记录里,而POST中的参数不会被保留
* GET请求在URL中传送的参数是有长度限制的,而POST没有限制·对参数的数据类型,GET只接受ASCIl字符,而POST没有限制
* GET比POST更不安全,因为参数直接暴露在URL上,所以不能用来传递敏感信息
* GET参数通过URL传递,POST放在Request body中
上面这些大多是浏览器和服务器的实现习惯,不是 HTTP 规范的规定:规范没有限制 URL 长度(限制来自浏览器和服务器,常见是 8KB 左右);POST 的 body 一样是明文,没有 HTTPS 时两者都不安全。真正本质的区别是语义:GET 安全且幂等,可以被缓存、预取和重试;POST 不是。被问到时先答语义,再列这些表现层差异,会显得更有深度。
14.5 HTTP 状态码
* 1xx:指示信息-表示请求已接收,继续处理
* 2xx:成功-表示请求已被成功接收
* 3xx:重定向-要完成请求必须进行更进一步的操作
* 4xx:客户端错误-请求有语法错误或请求无法实现
* 5xx:服务器错误-服务器未能实现合法的请求

* 101 Switching Protocols:协议切换,WebSocket 握手成功时返回
* 200 OK:客户端请求成功
* 204 No Content:成功但没有响应体,常见于 DELETE 和 CORS 预检
* 206 Partial Content:客户发送了一个带有Range头的GET请求,服务器完成了它(断点续传、视频拖动)
* 301 Moved Permanently:所请求的页面已经转移至新的url
* 302 Found:所请求的页面已经临时转移至新的url
* 304 Not Modified:客户端有缓冲的文档并发出了一个条件性的请求,服务器告诉客户,原来缓冲的文档还可以继续使用
* 307 / 308:临时 / 永久重定向,和 302 / 301 的区别是不允许把 POST 改成 GET
* 400 Bad Request:客户端请求有语法错误,不能被服务器所理解
* 401 Unauthorized:未认证(没登录),这个状态代码必须和WWW-Authenticate报头域一起使用
* 403 Forbidden:已认证但没有权限,对被请求页面的访问被禁止
* 404 Not Found:请求资源不存在
* 429 Too Many Requests:请求过于频繁,被限流
* 500 Internal Server Error:服务器发生不可预期的错误
* 502 Bad Gateway:网关或代理从上游服务器收到了无效响应
* 503 Service Unavailable:请求未完成,服务器临时过载或当机,一段时间后可能恢复正常
* 504 Gateway Timeout:网关或代理等待上游服务器超时
14.6 持久连接
HTTP 协议采用“请求-应答”模式,当使用普通模式,即非 Keep-Alive 模式时,每个请求/应答客户和服务器都要新建一个连接,完成之后立即断开连接(HTTP 协议为无连接的协议)
当使用 Keep-Alive 模式(又称持久连接、连接重用)时,Keep-Alive 功能使客户端到服务器端的连接持续有效,当出现对服务器的后继请求时,Keep-Alive 功能避免了建立或者重新建立连接
HTTP/1.1 默认就是持久连接,不需要再显式带 Connection: keep-alive。
14.7 管线化
在使用持久连接的情况下,某个连接上消息的传递类似于: 请求 1->响应 1->请求 2->响应 2->请求 3->响应 3 某个连接上的消息变成了类似这样: 请求 1>请求 2->请求 3->响应 1->响应 2->响应 3
* 管线化机制通过持久连接完成,仅HTTP/1.1支持此技术
* 只有GET和HEAD请求可以进行管线化,而POST则有所限制
* 初次创建连接时不应启动管线机制,因为对方(服务器)不一定支持HTTP/1.1版本的协议
* 管线化不会影响响应到来的顺序,如上面的例子所示,响应返回的顺序并未改变
* HTTP/1.1要求服务器端支持管线化,但并不要求服务器端也对响应进行管线化处理,只是要求对于管线化的请求不失败即可
* 由于上面提到的服务器端问题,开启管线化很可能并不会带来大幅度的性能提升,而且很多服务器端和代理程序对管线化的支持并不好,因此现代浏览器如Chrome和Firefox默认并未开启管线化支持
管线化的根本问题是队头阻塞:响应必须按顺序返回,前一个慢了后面全部要等。所以 HTTP/1.1 时代浏览器只能对同一域名开 6 个左右的 TCP 连接来并发,也因此才有了雪碧图、合并文件、域名分片这些优化手段。
- HTTP/2:二进制分帧 + 多路复用,一个 TCP 连接上并发多个请求流,解决了 HTTP 层的队头阻塞;还有 HPACK 头部压缩。上面那些「合并请求」的优化在 HTTP/2 下大多不再必要。但 TCP 丢包时整条连接仍会卡住(TCP 层的队头阻塞)。
- HTTP/3:基于 UDP 上的 QUIC,每个流独立做丢包重传,彻底解决队头阻塞;TLS 1.3 内置在 QUIC 握手里,首次连接 1-RTT、恢复连接可以 0-RTT;支持切换网络(Wi-Fi 切 4G)时连接迁移不断线。
现在主流 CDN 和浏览器都已支持 HTTP/3,DevTools Network 面板的 Protocol 列可以看到 h2 / h3。
14.8 HTTP 与 HTTPS
* HTTP的URL为http://开头,HTTPS的URL为https://开头
* HTTP标准端口80,HTTPS标准端口是443
* HTTPS = HTTP + TLS,HTTP 仍然工作在应用层,只是在 HTTP 和 TCP 之间多了一层 TLS 负责加密
* HTTP是明文传输,可能被窃听、篡改、冒充;HTTPS 提供加密、完整性校验和身份认证
* HTTP无需证书,HTTPS需要由受信任的 CA 机构颁发的证书(现在大多用 Let's Encrypt 这类免费证书自动签发)
HTTPS 的握手过程见下面一节。现在浏览器会把 HTTP 页面标为「不安全」,Service Worker、地理定位、剪贴板等很多 API 也只在安全上下文(HTTPS 或 localhost)里可用,HTTPS 已经是默认选项。
14.8.1 HTTPS 握手过程
HTTPS 用非对称加密交换密钥,再用对称加密传数据(非对称太慢,对称密钥又不能明文传),用证书保证拿到的公钥确实属于这个网站。以 TLS 1.2(ECDHE 密钥交换)为例:
- Client Hello:客户端发送支持的 TLS 版本、加密套件列表、客户端随机数
- Server Hello:服务端选定版本和加密套件,返回服务端随机数、证书、ECDHE 公钥参数(用证书私钥签名)
- 校验证书:客户端沿证书链验证到内置的根 CA,检查域名、有效期、是否吊销,再用证书公钥验签 ECDHE 参数,确认没被中间人替换
- 密钥交换:客户端发送自己的 ECDHE 公钥,双方各自用 ECDHE 算出同一个预主密钥,再结合两个随机数生成会话密钥
- Finished:双方用会话密钥加密一条校验消息,确认握手过程没被篡改,之后的 HTTP 数据都用对称加密(如 AES-GCM)传输
TLS 1.2 握手需要 2 个 RTT。TLS 1.3(现在的主流)做了简化:客户端在 Client Hello 里直接带上密钥交换参数,1 个 RTT 完成握手,会话恢复还能 0-RTT;同时删掉了 RSA 密钥交换等不安全的算法,只保留具备前向安全性的 (EC)DHE。
14.9 cookies和session的区别
- 存储位置不同:cookie的数据信息存放在客户端浏览器上,session的数据信息存放在服务器上。
- 存储容量不同:单个cookie保存的数据<=4KB,每个域名能存的 Cookie 数量有限(早期规范是 20 个,现在浏览器一般在 50~180 个),而对于session来说并没有上限,但出于对服务器端的性能考虑,session内不要存放过多的东西,并且设置session删除机制。
- 存储方式不同:cookie 只能存字符串,非 ASCII 字符(比如中文)要先用
encodeURIComponent编码;session 存在服务端,能存任何类型的数据。 - 隐私策略不同:cookie对客户端是可见的,别有用心的人可以分析存放在本地的cookie并进行cookie欺骗,所以它是不安全的,而session存储在服务器上,对客户端是透明的,不存在敏感信息泄漏的风险。
- 有效期上不同:开发可以通过设置cookie的属性,达到使cookie长期有效的效果。session一般依赖于一个保存 session id 的会话 cookie(如 Java 的 JSESSIONID),这个 cookie 默认关闭浏览器就失效,服务端的 session 也会有过期时间,因而session通常不会长期有效。
- 服务器压力不同:cookie保管在客户端,不占用服务器资源。对于并发用户十分多的网站,cookie是很好的选择。session是保管在服务器端的,每个用户都会产生一个session。假如并发访问的用户十分多,会产生十分多的session,耗费大量的内存。
- 跨域支持上不同:cookie 可以通过
Domain属性在同一主域的子域之间共享,但不能跨不同主域;session 本身存在服务端,跨域共享要靠共享 session 存储(如 Redis)或单点登录。
Cookie 的几个安全属性必须会:HttpOnly(JS 读不到,防 XSS 偷 cookie)、Secure(只走 HTTPS)、SameSite(Strict / Lax / None,控制跨站请求是否携带)。Chrome 80(2020 年)起没写 SameSite 的 cookie 默认按 Lax 处理,跨站场景必须显式 SameSite=None; Secure。
第三方 Cookie 方面:Safari 和 Firefox 默认拦截;Chrome 在 2024~2025 年放弃了全面禁用第三方 Cookie 的计划,但嵌入式场景仍推荐用 Partitioned(CHIPS)分区 Cookie。
另外,前后端分离和多端场景下常用 Token(如 JWT)放在 Authorization 头里做无状态认证,代价是不好主动失效,一般配合短期 access token + refresh token 使用。
14.10 WebSocket和HTTP
14.10.1 相同点
- 都是一样基于TCP的,都是可靠性传输协议。
- 都是应用层协议。
14.10.2 不同点
- WebSocket是双向通信协议,模拟Socket协议,可以双向发送或接受信息。HTTP是请求-响应模式,只能由客户端发起。
- WebSocket需要先通过一次 HTTP 请求握手(
Upgrade: websocket,服务器返回101 Switching Protocols),之后升级为 WebSocket 协议,在同一个 TCP 连接上持续通信。 - WebSocket 建立后是长连接,数据帧头部很小;HTTP 每次请求都要带完整的头部。
只需要服务端单向推送时(比如消息通知、AI 对话的流式输出),用基于 HTTP 的 SSE 更简单,见下一节;需要低延迟、不可靠传输的场景还有基于 HTTP/3 的 WebTransport。
14.11 SSE(Server-Sent Events)
SSE 是 HTML 标准里定义的服务端单向推送机制:客户端发一个普通的 HTTP 请求,服务端不结束响应,而是保持连接,持续往里写事件。它本身不是新协议,就是一个永远不结束的 HTTP 响应,所以天然能用上现有的 HTTP 基础设施(鉴权 Cookie、HTTP/2 多路复用、代理、CDN)。
ChatGPT 这类 AI 对话「一个字一个字往外蹦」的效果,以及 OpenAI、Anthropic 等大模型 API 的流式输出,用的都是 SSE 格式,这也是它这几年重新变成高频考点的原因。
14.11.1 协议格式
响应头:
HTTP/1.1 200 OK
Content-Type: text/event-stream
Cache-Control: no-cache
Connection: keep-alive
响应体是 UTF-8 纯文本,每个事件由若干 字段: 值 行组成,以一个空行结束:
: 冒号开头的是注释,常用来定时发送心跳,防止连接被代理断开

data: 第一条消息

id: 2
event: notice
data: {"title": "多行 data 会用换行拼起来"}
data: {"second": "line"}

retry: 5000
data: 断线后 5 秒重连
data:消息内容,一个事件可以有多行data,客户端收到后用\n拼接event:事件类型,不写默认是messageid:事件 id。断线重连时浏览器会自动带上请求头Last-Event-ID,服务端据此补发漏掉的消息retry:告诉浏览器断线后多少毫秒重连
14.11.2 浏览器端:EventSource
const es = new EventSource('/api/events', { withCredentials: true }) // 跨域时是否带 Cookie

es.onopen = () => console.log('connected')
// 没有 event 字段的消息
es.onmessage = (e) => console.log(e.data, e.lastEventId)
// 自定义事件类型要用 addEventListener 监听
es.addEventListener('notice', (e) => console.log(JSON.parse(e.data)))
// 出错后浏览器会自动重连,readyState 为 CLOSED 时才是彻底断开
es.onerror = () => {
  if (es.readyState === EventSource.CLOSED) console.log('closed')
}

// 不需要时主动关闭,否则会一直重连
es.close()
14.11.3 服务端:Node.js 示例
import http from 'node:http'

http
  .createServer((req, res) => {
    res.writeHead(200, {
      'Content-Type': 'text/event-stream',
      'Cache-Control': 'no-cache',
      Connection: 'keep-alive',
      'X-Accel-Buffering': 'no', // 让 nginx 不要缓冲,否则消息会攒一批才发出
    })
    let id = Number(req.headers['last-event-id'] ?? 0)
    const timer = setInterval(() => {
      id++
      res.write(`id: ${id}\ndata: ${JSON.stringify({ time: Date.now() })}\n\n`)
    }, 1000)
    // 客户端断开时清理,否则定时器会泄漏
    req.on('close', () => clearInterval(timer))
  })
  .listen(3000)
14.11.4 AI 流式输出:用 fetch 读 SSE
EventSource 有几个硬伤:只能发 GET 请求,不能自定义请求头(没法带 Authorization),也没法传请求体。大模型对话需要 POST 一大段上下文,所以实际项目里都是用 fetch 发请求,再自己按 SSE 格式解析响应流:
async function chat(messages, onDelta, signal) {
  const res = await fetch('/api/chat', {
    method: 'POST',
    headers: { 'Content-Type': 'application/json', Authorization: `Bearer ${token}` },
    body: JSON.stringify({ messages, stream: true }),
    signal, // 传入 AbortController.signal 就能实现「停止生成」
  })
  if (!res.ok) throw new Error(`HTTP ${res.status}`)

  const reader = res.body.pipeThrough(new TextDecoderStream()).getReader()
  let buffer = ''
  while (true) {
    const { value, done } = await reader.read()
    if (done) break
    buffer += value
    // 网络分包不会按事件边界切,一个 chunk 里可能有半个事件,必须先缓存再按空行切分
    const events = buffer.split('\n\n')
    buffer = events.pop() // 最后一段可能不完整,留到下次
    for (const event of events) {
      const data = event
        .split('\n')
        .filter((line) => line.startsWith('data:'))
        .map((line) => line.slice(5).trimStart())
        .join('\n')
      if (!data || data === '[DONE]') continue // OpenAI 风格的接口用 [DONE] 表示结束
      onDelta(JSON.parse(data))
    }
  }
}这里最容易被追问的就是分包:TCP 和代理不保证一次 read() 正好是一个完整事件,直接对每个 chunk 做 JSON.parse 会偶发报错。规范里换行也可能是 \r\n,生产环境建议直接用 eventsource-parser 这类库,或者 Vercel AI SDK 这种封装好的方案。
14.11.5 SSE、WebSocket、轮询怎么选
| 短轮询 | 长轮询 | SSE | WebSocket | |
|---|---|---|---|---|
| 方向 | 客户端拉 | 客户端拉 | 服务端 → 客户端 | 双向 |
| 协议 | HTTP | HTTP | HTTP | 独立协议(HTTP 升级) |
| 数据格式 | 任意 | 任意 | UTF-8 文本 | 文本 / 二进制 |
| 断线重连 | 不涉及 | 手动 | 浏览器自动,带 Last-Event-ID 续传 | 手动实现 |
| 实时性 | 差,取决于轮询间隔 | 较好 | 好 | 好 |
| 适用场景 | 低频状态查询 | 兼容老环境 | 通知、行情、日志、AI 流式输出 | 聊天、协同编辑、游戏 |
几个注意点:
- 连接数限制:HTTP/1.1 下浏览器对同一域名最多 6 个连接,每个 SSE 都会长期占一个,多开几个标签页就可能把其他请求卡住。HTTP/2 下多个流复用一条连接,没有这个问题,所以 SSE 服务一定要上 HTTP/2。
- 代理和压缩:nginx 默认会缓冲响应,要关掉
proxy_buffering或返回X-Accel-Buffering: no;开启 gzip 的中间层也可能把数据攒着不发。 - 超时:负载均衡和网关通常有空闲超时(比如 60 秒),长时间没数据要发注释行做心跳。
- Serverless 平台:函数有最长执行时间,长连接推送要确认平台支持流式响应。
面试一句话总结:单向推送优先 SSE,简单、基于 HTTP、自动重连;需要客户端高频上行或二进制数据再用 WebSocket。
十五、通信
- 什么是同源策略及限制
- 前后端如何通信
- 如何创建 Ajax
- 跨域通信的几种方式
15.1 什么是同源策略及限制
同源策略限制从一个源加载的文档或脚本如何与来自另一个源的资源进行交互。这是一个用于隔离潜在恶意文件的关键的安全机制。
- cookie,localstorage 和 IndexDB 无法读取
- DOM 无法获取
- Ajax 请求不能发送
15.2 前后端如何通信
- Ajax(XMLHttpRequest / fetch)
- WebSocket
- CORS
- SSE(EventSource,见 12.11)
15.3 如何创建 Ajax(code)
- XMLHttpRequest 对象的工作流程
- 兼容性处理
- 事件的触发条件
- 事件的触发顺序
// XMLHttpRequest
const xhr = new XMLHttpRequest()
xhr.open('GET', '/api/user?id=1', true) // true 表示异步
xhr.onreadystatechange = function () {
  // readyState: 0 未初始化 1 已 open 2 收到响应头 3 接收响应体中 4 完成
  if (xhr.readyState !== 4) return
  if ((xhr.status >= 200 && xhr.status < 300) || xhr.status === 304) {
    console.log(JSON.parse(xhr.responseText))
  }
}
xhr.onerror = () => console.error('network error')
xhr.send(null)

// fetch:现在的标准写法
const controller = new AbortController()
const res = await fetch('/api/user?id=1', {
  method: 'GET',
  signal: AbortSignal.any([controller.signal, AbortSignal.timeout(5000)]), // 手动取消 + 超时
})
// 注意:fetch 只有网络错误才会 reject,404 / 500 也是 resolve,要自己判断 res.ok
if (!res.ok) throw new Error(`HTTP ${res.status}`)
const data = await res.json()兼容性处理(ActiveXObject)只是 IE6 时代的事。XHR 现在主要剩下一个优势:xhr.upload.onprogress 可以拿到上传进度,fetch 目前还没有标准的上传进度事件。
15.4 跨域通信的几种方式(code)
- 通过 JSONP 跨域
- CORS
- document.domain + iframe 跨域
- location.hash + iframe
- window.name + iframe 跨域
- postMessage
- nginx 代理跨域
- nodejs 中间件代理跨域
- WebSocket 协议跨域
- webpack proxy
15.4.1 jsonp
优缺点:
- JSONP 是服务器与客户端跨源通信的常用方法。最大特点就是简单适用,老式浏览器全部支持,服务器改造非常小。
- 只能实现 get 一种请求、不安全 容易遭到 xss 攻击
<script>
  // 全局回调要在请求脚本之前定义
  function jsonp(data) {
    console.log(data)
  }
</script>
<!-- 服务端返回的内容是:jsonp({"name":"wudi"}) -->
<script src="http://www.abc.com/?data=name&callback=jsonp" charset="utf-8"></script>
15.4.2 CORS
CORS 是一个 W3C 标准(现在定义在 WHATWG Fetch 规范里),全称是"跨域资源共享"(Cross-origin resource sharing)它允许浏览器向跨源服务器,发出 XMLHttpRequest / fetch 请求,从而克服了 AJAX 只能同源使用的限制。 普通跨域请求:只服务端设置 Access-Control-Allow-Origin 即可,前端无须设置,若要带 cookie 请求:前后端都需要设置。由于同源策略的限制,所读取的 cookie 为跨域请求接口所在域的 cookie,而非当前页 优缺点:
- 目前,所有浏览器都支持该功能,CORS 也已经成为主流的跨域解决方案。
- 整个 CORS 通信过程,都是浏览器自动完成,不需要用户参与。对于开发者来说,CORS 通信与同源的 AJAX 通信没有差别,代码完全一样。浏览器一旦发现 AJAX 请求跨源,就会自动添加一些附加的头信息,有时还会多出一次附加的请求,但用户不会有感觉。
- CORS 与 JSONP 的使用目的相同,但是比 JSONP 更强大。JSONP 只支持 GET 请求,CORS 支持所有类型的 HTTP 请求。JSONP 的优势在于支持老式浏览器,以及可以向不支持 CORS 的网站请求数据。
// 带 cookie 的跨域请求
fetch('https://api.b.com/user', {
  method: 'POST',
  credentials: 'include', // XHR 对应 xhr.withCredentials = true
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify({ id: 1 }),
})
# 服务端响应头
Access-Control-Allow-Origin: https://www.a.com # 带 cookie 时不能写 *,必须是具体的源
Access-Control-Allow-Credentials: true
Access-Control-Allow-Methods: GET, POST, PUT
Access-Control-Allow-Headers: Content-Type, Authorization
Access-Control-Max-Age: 86400 # 预检结果缓存时间CORS 请求分两类,这是面试必问点:
- 简单请求:方法是 GET / HEAD / POST,且只带了
Accept、Content-Type(限text/plain、multipart/form-data、application/x-www-form-urlencoded)等少数安全头部。浏览器直接发请求,根据响应头决定是否把结果交给 JS。 - 预检请求:其他情况(比如
Content-Type: application/json、PUT / DELETE、自定义头Authorization),浏览器先发一个OPTIONS请求询问服务器,通过后才发真正的请求。
注意 CORS 拦截的是响应:简单请求其实已经到达服务器并执行了,只是浏览器不让 JS 读结果,所以 CORS 不能用来防 CSRF。
15.4.3 document.domain + iframe 跨域
此方案仅限主域相同,子域不同的跨域应用场景(网页一级域名相同,只是二级域名不同)。 实现原理:两个页面都通过 js 强制设置 document.domain 为基础主域,就实现了同域。
⚠️ 已废弃:Chrome 115 起默认禁止修改
document.domain(除非响应头声明Origin-Agent-Cluster: ?0),其他浏览器也在跟进,新项目请用 postMessage。下面的location.hash、window.name方案同样只有历史意义,了解原理即可。
<!-- 父窗口:(www.a.com/a.html) -->
<iframe id="iframe" src="http://child.a.com/b.html"></iframe>
<script>
  document.domain = 'a.com'
  let user = 'admin'
</script>

<!-- 子窗口:(child.a.com/b.html) -->
<script>
  document.domain = 'a.com'
  // 获取父窗口中变量
  alert('get js data from parent ---> ' + window.parent.user)
</script>
15.4.4 location.hash
利用 hash,场景是当前页面 A 通过 iframe 或 frame 嵌入了跨域的页面 B
// 在A中伪代码如下:
let Biframe = document.getElementsByTagName('iframe')
Biframe.src += '#data'

// 在B中的伪代码如下
window.onhashchange = function () {
  let data = window.location.hash
}
15.4.5 window.name + iframe 跨域
window.name 这个属性不是一个简单的全局属性 --- 只要在一个 window 下,无论 url 怎么变化,只要设置好了 window.name,那么后续就一直都不会改变,同理,在 iframe 中,即使 url 在变化,iframe 中的 window.name 也是一个固定的值
// 1.  a.html:(www.a.com/a.html)

const iframeNameProxy = (url, callback) => {
  let iframe = document.createElement('iframe')
  let state = 0

  // 加载跨域页面
  iframe.src = url

  // onload事件会触发2次,第1次加载跨域页,并留存数据于window.name
  iframe.onload = function () {
    if (state === 1) {
      // 第2次onload(同域c页)成功后,读取同域window.name中数据
      callback(iframe.contentWindow.name)
      destoryFrame()
    } else if (state === 0) {
      // 第1次onload(跨域页)成功后,切换到同域代理页面
      iframe.contentWindow.location = 'http://www.a.com/c.html'
      state = 1
    }
  }

  document.body.appendChild(iframe)

  // 获取数据以后销毁这个iframe,释放内存;同时也保证了安全(不被其他域frame js访问)
  function destoryFrame() {
    iframe.contentWindow.document.write('')
    iframe.contentWindow.close()
    document.body.removeChild(iframe)
  }
}

// 请求跨域b页面数据
iframeNameProxy('http://www.b.com/b.html', (data) => {
  alert(data)
})

// 2.  c.html:(www.a.com/c.html)
// src设置为当前域的c.html,中间代理页,与a.html同域,内容为空即可

// 3.  b.html:(www.b.com/b.html)
const person = {
  name: 'WuChenDi',
  age: 23,
}
window.name = JSON.stringify(person)
15.4.6 postMessage
窗口 A(http://A.com)向跨域的窗口 B(http://B.com)发送信息
// 窗口A:Bwindow 是 B 的窗口引用,比如 iframe.contentWindow 或 window.open 的返回值
// 第二个参数指定目标源,不要图省事写 '*',否则数据可能被发给恶意页面
Bwindow.postMessage('data', 'http://B.com')

// 在窗口B中监听
window.addEventListener(
  'message',
  function (event) {
    // 一定要校验来源,否则任何页面都能给你发消息
    if (event.origin !== 'http://A.com') return
    console.log(event.origin)
    console.log(event.source) // A 的窗口引用,可以用 event.source.postMessage 回复
    console.log(event.data)
  },
  false
)
postMessage 也是 Web Worker、iframe 微前端、BroadcastChannel(同源多标签页通信)背后的同一套机制。
15.4.7 nginx 代理跨域
server {
    listen       80;
    server_name  localhost;

    # 匹配以/apis/开头的请求
    location ^~ /apis/ {
        proxy_pass http://www.xxx.com/; #反向代理
        proxy_cookie_domain www.xxx.com localhost; #把后端写的 cookie 域名改成当前域名
    }

    location / {
        root   html;
        index  index.html index.htm;
    }

    #error_page  404              /404.html;

    # redirect server error pages to the static page /50x.html
    #
    error_page   500 502 503 504  /50x.html;
    location = /50x.html {
        root   html;
    }
}
15.4.8 WebSocket
WebSocket 是 HTML5 开始提供的一种在单个 TCP 连接上进行全双工通讯的协议。 使用 ws://(非加密)和wss://(加密)作为协议前缀。 该协议不实行同源政策,只要服务器支持,就可以通过它进行跨源通信。
15.4.9 webpack的proxy是如何解决跨域的?
其实这里就像是反向代理一样。我们在使用webpack开发项目的时候,webpack的dev-server模块会启动一个服务器,这个服务器不止帮我们做了自动更新,同时也可以做到反向代理。就是我们把请求发送给webpack-dev-server, 然后webpack-dev-server再去请求后端服务器,服务之间的请求是没有跨域问题的,只要后端返回了webpack-dev-server就能拿到,然后再返回给前端。这也就是上面列表里的「nodejs 中间件代理跨域」,webpack-dev-server 内部用的就是 http-proxy-middleware。
Vite 的 server.proxy 原理相同。注意这只在本地开发时生效,上线后要靠 nginx 反向代理或后端配置 CORS。
链接参考:
- http://www.ruanyifeng.com/blog/2016/04/cors.html
- https://juejin.cn/post/5c9c38e2e51d452db7007f66#heading-7
十六、安全
16.1 XSS
16.1.1 概念
XSS (Cross Site Scripting),即跨站脚本攻击,是一种常见于 Web 应用中的计算机安全漏洞。恶意攻击者往 Web 页面里嵌入恶意的客户端脚本,当用户浏览此网页时,脚本就会在用户的浏览器上执行,进而达到攻击者的目的。比如获取用户的 Cookie、导航到恶意网站、携带木马等。
按恶意脚本的来源分三类:
- 存储型:恶意代码存进了数据库(评论、昵称),所有访问该页面的用户都会中招,危害最大;
- 反射型:恶意代码放在 URL 参数里,服务端原样拼进页面返回,需要诱导用户点击链接;
- DOM 型:前端 JS 把不可信数据直接写进 DOM(
innerHTML、eval、location),全程不经过服务端。
16.1.2 常见攻击方法
- 绕过 XSS-Filter,利用<>标签注入 Html/JavaScript 代码;
- 利用 HTML 标签的属性值进行 xss 攻击。例如:
<img src="javascript:alert('xss')" />;(当然并不是所有的 Web 浏览器都支持JavaScript伪协议,所以此类 XSS 攻击具有一定的局限性) - 空格、回车和 Tab。如果 XSS Filter 仅仅将敏感的输入字符列入黑名单,比如
JavaScript,用户可以利用空格、回车和 Tab 键来绕过过滤,例如:<img src="javas cript:alert(/xss/)" />; - 利用事件来执行跨站脚本。例如:
<img src="#" onerror="alert(1)" />,当 src 错误的视乎就会执行 onerror 事件; - 利用 CSS 跨站。例如:
body {background-image: url("javascript:alert('xss')" )};(只在旧 IE 里有效,现代浏览器已不执行 CSS 里的 javascript: 伪协议) - 利用字符编码,透过这种技巧,不仅能让 XSS 代码绕过服务端的过滤,还能更好地隐藏 Shellcode;(JS 支持 unicode、eacapes、十六进制、十进制等编码形式)
- 拆分跨站法,将 XSS 攻击的代码拆分开来,适用于应用程序没有过滤 XSS 关键字符(如<、>)却对输入字符长度有限制的情况下;
- DOM 型的 XSS 主要是由客户端的脚本通过 DOM 动态地输出数据到页面上,它不依赖于提交数据到服务器,而是从客户端获得 DOM 中的数据在本地执行。容易导致 DOM 型的 XSS 的输入源包括:
Document.URL、Location(.pathname|.href|.search|.hash)、Document.referrer、Window.name、Document.cookie、localStorage/globalStorage;
16.1.3 防御措施
原则不相信客户输入的数据 注意: 攻击代码不一定在
<script></script>中
- 使用
XSS Filter
输入过滤,对用户提交的数据进行有效性验证,仅接受指定长度范围内并符合我们期望格式的的内容提交,阻止或者忽略除此外的其他任何数据。比如:电话号码必须是数字和中划线组成,而且要设定长度上限。过滤一些些常见的敏感字符,例如:< > ' " & # \ javascript expression "onclick=" "onfocus"过滤或移除特殊的 Html 标签。 例如: <script>,<iframe>,<for <, > for >, " for;过滤 JavaScript 事件的标签,例如 onclick=,onfocus 等等。
输出编码,当需要将一个字符串输出到 Web 网页时,同时又不确定这个字符串中是否包括 XSS 特殊字符(如 < > &' " 等),为了确保输出内容的完整性和正确性,可以使用编码 HTMLEncode 进行处理。
DOM型的XSS攻击防御
把变量输出到页面时要做好相关的编码转义工作,如要输出到 <script>中,可以进行 JS 编码;要输出到 HTML 内容或属性,则进行 HTML 编码处理。根据不同的语境采用不同的编码处理方式。
HttpOnly Cookie
将重要的 cookie 标记为 http only, 这样的话当浏览器向 Web 服务器发起请求的时就会带上 cookie 字段,但是在脚本中却不能访问这个 cookie,这样就避免了 XSS 攻击利用 JavaScript 的 document.cookie 获取 cookie
16.1.3.1 转义字符
function escapeHtml(str) {
if (!str) return
str = str.replace(/&/g, '&')
str = str.replace(/</g, '<')
str = str.replace(/>/g, '>')
str = str.replace(/"/g, '"')
str = str.replace(/'/g, ''')
str = str.replace(/`/g, '`')
str = str.replace(/\//g, '/')
return str
}
// use
escapeHtml('<script>alert(1)</script>')
// <script>alert(1)</script>但是对于显示富文本来说,显然不能通过上面的办法来转义所有字符,因为这样会把需要的格式也过滤掉。对于这种情况,通常采用白名单过滤的办法,当然也可以通过黑名单过滤,但是考虑到需要过滤的标签和标签属性实在太多,更加推荐使用白名单的方式。
推荐使用 js-xss 或 DOMPurify
现代框架已经帮你挡掉了大部分 XSS:React 的 JSX、Vue 的 {{ }} 插值默认都会转义。真正的风险点集中在「主动绕过」的 API 上:React 的 dangerouslySetInnerHTML、Vue 的 v-html、直接写 innerHTML、把用户输入拼进 href(javascript: 链接)。这些地方必须先用 DOMPurify 清洗。
再往上一层是浏览器提供的纵深防御:CSP(见 14.3)限制能执行哪些脚本;Trusted Types(require-trusted-types-for 'script')让 innerHTML 这类危险 API 只接受经过策略处理的值,从源头杜绝 DOM 型 XSS。另外浏览器原生的 Element.setHTML()(Sanitizer API)也在逐步落地。
16.2 CSRF
16.2.1 概念
CSRF(Cross-site request forgery)跨站请求伪造,也被称为“One Click Attack”或者 Session Riding,通常缩写为 CSRF 或者 XSRF,是一种对网站的恶意利用。
16.2.2 攻击原理
sequenceDiagram
  participant U as 用户浏览器
  participant A as 网站 A(已登录)
  participant B as 网站 B(恶意)
  U->>A: 1. 登录
  A-->>U: 2. 下发 Cookie
  U->>B: 3. 访问网站 B
  B-->>U: 4. 返回页面,引诱点击
  U->>A: 5. 向网站 A 发出请求,浏览器自动带上 A 的 Cookie
  Note over A: 6. A 以为是用户本人操作
CSRF 攻击的主要目的是让用户在不知情的情况下攻击自己已登录的一个系统,类似于钓鱼。如用户当前已经登录了邮箱,或 bbs,同时用户又在使用另外一个,已经被你控制的站点,我们姑且叫它钓鱼网站。这个网站上面可能因为某个图片吸引你,你去点击一下,此时可能就会触发一个 js 的点击事件,构造一个 bbs 发帖的请求,去往你的 bbs 发帖,由于当前你的浏览器状态已经是登陆状态,所以 session 登陆 cookie 信息都会跟正常的请求一样,纯天然的利用当前的登陆状态,让用户在不知情的情况下,帮你发帖或干其他事情。
16.2.3 防御措施
CSRF 能成立的前提是「跨站请求会自动带上目标站的 Cookie」。Chrome 80 起 Cookie 默认 SameSite=Lax,跨站的 POST、iframe、fetch 都不再携带 Cookie,大部分经典 CSRF 已经被浏览器默认挡住。现在推荐的组合是:
- 登录态 Cookie 显式设置
SameSite=Lax(或Strict); - 服务端校验
Origin头或 Fetch Metadata 请求头Sec-Fetch-Site,拒绝cross-site的写操作; - 关键操作仍保留 CSRF Token 或二次验证,作为兜底;
- 用
Authorization头携带 Token 的接口天然不受 CSRF 影响(浏览器不会自动带这个头)。
注意 GET 请求不能有副作用,因为 SameSite=Lax 依然允许顶层导航的 GET 携带 Cookie。
16.2.3.1 面试大白话
- 通过 referer、token 或者 验证码 来检测用户提交
- 尽量不要在页面的链接中暴露用户隐私信息
- 对于用户修改删除等操作最好都使用 post 操作
- 避免全站通用的 cookie,严格设置 cookie 的域
16.2.3.2 验证码
原理:
CSRF攻击过程中,用户在不知情的情况下构造了网络请求,添加验证码后,强制用户必须与应用进行交互

*  优点:简洁而有效
*  缺点:网站不能给所有的操作都加上验证码
16.2.3.3 Referer Check
原理:
* 利用HTTP头中的Referer判断请求来源是否合法
* Referer首部包含了当前请求页面的来源页面的地址,一般情况下Referer的来源页就是发起请求的那个页面,如果是在iframe中发起的请求,那么对应的页面URL就是iframe的src

*  优点:简单易操作(只需要在最后给所有安全敏感的请求统一添加一个拦截器来检查Referer的值就行)
*  缺点:服务器并非什么时候都能取到Referer
        1.很多出于保护用户隐私的考虑,限制了Referer的发送。
        2.比如从HTTPS跳转到HTTP,出于安全的考虑,浏览器不会发送Referer
16.2.3.4 Anti CSRF Token
原理:把参数加密,或者使用一些随机数,从而让攻击者无法猜测到参数值,也就无法构造请求的 URL,也就无法发起 CSRF 攻击。

例子(增加token):
*  比如一个删除操作的URL是:`https://host/v1/user/crowd/delete?id=0530`
*  保持原参数不变,新增一个参数Token,Token值是随机的,不可预测
*  `https://host/v1/user/crowd/delete?id=0530&token=${getToken()}`

*  优点:比检查Referer方法更安全,并且不涉及用户隐私
*  缺点:
        加密
        1. 加密后的URL非常难读,对用户非常不友好
        2. 加密的参数每次都在改变,导致用户无法对页面进行搜索
        3. 普通参数也会被加密或哈希,将会给DBA工作带来很大的困扰,因为数据分析常常需要用到参数的明文

        token
        1. 对所有的请求都添加Token比较困难(解决方案:可以使用代理请求方法处理)
16.3 CSP
CSP(Content Security Policy,内容安全策略)通过响应头告诉浏览器:这个页面只允许从哪些来源加载和执行资源。即使攻击者注入了脚本,浏览器也会拒绝执行,是防 XSS 最有效的纵深手段。
Content-Security-Policy: default-src 'self'; script-src 'self' 'nonce-r4nd0m' 'strict-dynamic'; object-src 'none'; base-uri 'none'; frame-ancestors 'none'default-src 'self':默认只允许同源资源;script-src配合每次请求随机生成的 nonce(<script nonce="r4nd0m">),只有带正确 nonce 的脚本才能执行,内联注入的脚本因此失效。这种 nonce +strict-dynamic的「严格 CSP」比维护一长串域名白名单更可靠;frame-ancestors:控制谁能用 iframe 嵌入本页,用来防点击劫持;- 上线前可以先用
Content-Security-Policy-Report-Only只上报不拦截,观察一段时间再正式启用。
也可以用 <meta http-equiv="Content-Security-Policy"> 设置,但 frame-ancestors 和上报相关指令在 meta 里不生效。
16.4 中间人攻击
中间人攻击(MITM)是攻击者插在客户端和服务器之间,同时伪装成双方,从而窃听或篡改通信内容。常见场景是公共 Wi-Fi、DNS 劫持、ARP 欺骗,以及运营商在 HTTP 页面里插广告。
防御措施:
- 全站 HTTPS:TLS 的加密防窃听,证书校验防冒充,MAC 防篡改;
- HSTS:响应头
Strict-Transport-Security: max-age=31536000; includeSubDomains; preload,让浏览器以后只用 HTTPS 访问,防止第一次被降级成 HTTP(SSL 剥离攻击)。加入浏览器的 HSTS preload 列表后,连第一次访问都会直接走 HTTPS; - 不要让用户忽略证书错误;App 里可以做证书固定(certificate pinning);
- 第三方 CDN 脚本加 SRI(
<script integrity="sha384-...">),被篡改就拒绝执行。
16.5 点击劫持
16.5.1 概念
点击劫持是一种视觉上的欺骗手段。攻击者使用一个透明的、不可见的iframe,覆盖在一个网页上,然后诱使用户在网页上进行操作,此时用户将在不知情的情况下点击透明的iframe页面。通过调整iframe页面的位置,可以诱使用户恰好点击在iframe页面的一些功能性按钮上。
16.5.2 防御措施
X-Frame-OptionsHTTP 响应头是用来给浏览器指示允许一个页面能否在<frame>、<iframe>、<object>中展现的标记,有三个可选的值:DENY:不允许当前页面被任何页面嵌入(即使是相同域名的页面也不允许)SAMEORIGIN:只允许被同源域名下的页面嵌入ALLOW-FROM uri:允许被指定来源嵌入(已废弃,现代浏览器不支持)
- 现在推荐用 CSP 的
frame-ancestors替代,它更灵活,可以指定多个来源:Content-Security-Policy: frame-ancestors 'self' https://trusted.com。两者同时存在时浏览器以frame-ancestors为准。 - 禁止 iframe 的嵌套(JS 防御,作为兜底;可以被 iframe 的
sandbox属性禁用脚本绕过):
if (window.top !== window.self) {
  window.top.location = window.self.location
}
16.6 依赖供应链安全
前端项目动辄上千个依赖,任何一个被投毒都会进入你的产物。2025 年 npm 上就出现过多起大规模事件:chalk、debug 等高下载量包的维护者账号被钓鱼后发布了带恶意代码的版本;Shai-Hulud 蠕虫会窃取开发机和 CI 里的 npm token,再用它自动感染受害者维护的其他包。
防御措施:
- 锁定版本:提交 lockfile,CI 里用
npm ci/pnpm install --frozen-lockfile,保证装的就是审过的版本。 - 延迟升级:新版本发布后等一段时间再用(pnpm 的
minimumReleaseAge),大部分投毒版本会在几小时到几天内被发现和下架。 - 限制安装脚本:恶意代码通常藏在
postinstall里。pnpm 10 起默认不执行依赖的生命周期脚本,需要的包用onlyBuiltDependencies显式放行。 - 发布侧:维护的包开启 2FA;用 npm 的 trusted publishing(CI 通过 OIDC 直接发布,不再保存长期 token),并附带 provenance 证明包是从哪个仓库、哪次构建产出的。
- CI 最小权限:流水线的 token 只给必需的权限;第三方 Action 固定到 commit hash;
npm audit或 Dependabot / Renovate 持续扫描。 - 运行时:第三方 CDN 脚本加 SRI,用 CSP 限制脚本来源。
16.7 登录态与 Token 存储
OAuth 2.0 / OIDC:OAuth 解决授权(第三方应用能代表用户访问哪些资源),OIDC 在它之上加了身份认证(用户是谁,返回 ID Token)。「用 GitHub 登录」就是 OIDC 的典型场景。
SPA 的标准做法是 授权码模式 + PKCE:
- 前端生成随机的
code_verifier,把它的哈希code_challenge带上跳转到授权服务器; - 用户登录、同意授权后,带着
code跳回应用; - 前端用
code+ 原始的code_verifier换取 token。授权服务器校验两者匹配,即使code在跳转中被截获也换不到 token。
以前 SPA 常用的隐式模式(token 直接放在 URL hash 里返回)已经不再推荐,OAuth 2.1 草案中也移除了它。
Token 存在哪里:
| 存储位置 | XSS 能偷走吗 | CSRF 风险 | 说明 |
|---|---|---|---|
| localStorage | 能 | 无 | 最简单,但一旦有 XSS,token 会被直接读走 |
| 内存(JS 变量) | 较难 | 无 | 刷新页面就丢,需要配合 refresh token 静默续期 |
| HttpOnly Cookie | 不能 | 有,靠 SameSite 防护 | JS 读不到,但请求会自动携带 |
推荐做法是 BFF 模式:由同域的后端完成 OAuth 流程,token 只保存在服务端,浏览器只拿到一个 HttpOnly; Secure; SameSite=Lax 的会话 Cookie。如果必须在前端持有 token,就让 access token 只放内存且有效期短,refresh token 放在 HttpOnly Cookie 里,并在每次刷新时轮换。
要注意,没有哪种存储方式能防住 XSS:页面一旦能执行恶意脚本,攻击者即使拿不到 token,也可以直接以用户身份发请求。根本的防线仍然是前面讲的 XSS 防护和 CSP。
十七、异常与监控
17.1 前端错误的分类
17.1.1 系统异常
系统异常比较少,相关可能为浏览器奔溃
17.1.2 网络异常
XMLHttpRequest请求异常Fetch请求异常- 静态资源加载异常
17.1.3 应用异常
- Error:错误的基类,其他错误都继承自该类型。
- EvalError : 与
eval()有关的错误。 - RangeError : 表示这个值不在允许值集或范围内。
- ReferenceError : 表示发现一个无效的引用。
- SyntaxError : 表示发生了解析错误。
- TypeError :当其它类型错误都不符合时,TypeError 用于指示一个不成功的操作。
- URIError :表示用于处理 URI 的函数(encodeURI 或 decodeURl)使用方式与其定义的不兼容。
- 异常参考:Top 10 JavaScript errors from 1000+ projects
17.2 异常捕获
17.2.1 try/catch/finally
try {
  var a = 1
  var b = a + c
} catch (error) {
  // 捕获处理
  console.log(error) // ReferenceError: c is not defined
  logger.error('catch', error)
} finally {
  throw new Error('error')
}
思考: 如果 catch 块和 finally 块都抛出异常,catch 块的异常是否能抛出?
不能。finally 块抛出的异常会覆盖 catch 块抛出的异常,外层只能捕获到 finally 的那个,catch 的异常就丢了(finally 里 return 也会吞掉异常)。因此,重要的是要么在捕获时记录异常,要么确保 finally 块本身不会引发异常。
另外 try/catch 只能捕获同步代码和 await 的异常,捕获不到 setTimeout 回调里或没有 await 的 Promise 中抛出的错误。
17.2.2 window.onerror
请注意
window.onerror能捕获 JS 运行时错误(包括异步回调里的),但无法捕获静态资源加载异常(资源的 error 事件不冒泡),也捕获不到 Promise 的 reject。
/**
 * @param {String}  message    错误信息
 * @param {String}  source     错误文件路径
 * @param {Number}  lineno     错误行号
 * @param {Number}  colno      错误列号
 * @param {Object}  error      Error对象(对象)
 */
window.onerror = function (message, source, lineno, colno, error) {
  console.log('捕获到异常:', { message, source, lineno, colno, error })
  logger.error('oneror', JSON.stringify({ message, source, lineno, colno, error }))
}
17.2.3 静态资源加载 异常
<script>
  function errorHandler(error) {
    console.log(`捕获到静态资源加载异常: ${error}`)
    logger.error('onerror', JSON.stringify(error))
  }
</script>

<script src="http://cdn.xxx.com/js/test.js" onerror="errorHandler(this)"></script>

<link
  rel="stylesheet"
  href="http://cdn.xxx.com/styles/index.css"
  onerror="errorHandler(this)"
/>
更通用的做法是在 window 上用捕获阶段统一监听,不用给每个标签加 onerror:
window.addEventListener(
  'error',
  (event) => {
    const target = event.target
    // 资源加载错误的 target 是元素;JS 运行时错误的 target 是 window
    if (target && target !== window && (target.src || target.href)) {
      logger.error('resource', target.src || target.href)
    }
  },
  true // 资源的 error 事件不冒泡,必须在捕获阶段监听
)
17.2.4 Promise 异常
window.addEventListener('unhandledrejection', (event) => {
  console.warn(`UNHANDLED PROMISE REJECTION: ${event.reason}`)
  logger.error('promise', JSON.stringify(event))

  event.preventDefault()
})

// 或
window.onunhandledrejection = (event) => {
  console.warn(`UNHANDLED PROMISE REJECTION: ${event.reason}`)
  logger.error('promise', JSON.stringify(event))

  event.preventDefault()
}
17.2.5 Vue
/**
 * @name Vue 2 异常上报
 * @param {{message,name,script,line,column,stack}} err error 对象
 * @param {String} vm 抛出异常的 Vue 实例对象
 * @param {String} info Vue 特定的错误信息,比如错误所在的生命周期钩子
 */
Vue.config.errorHandler = (err, vm, info) => {
  console.log('vue errorHandler', { err, vm, info })

  logger.error('vue error', JSON.stringify({ err, info }))
}

// Vue 3:挂在应用实例上,第二个参数是组件实例
const app = createApp(App)
app.config.errorHandler = (err, instance, info) => {
  logger.error('vue error', { message: err.message, stack: err.stack, info })
}
// 组件内还可以用 onErrorCaptured 捕获子组件错误,类似 React 的错误边界
(原来的写法里 JSON.stringify(vm) 会因为组件实例的循环引用直接报错,上报时只取需要的字段。)
17.2.6 React
import React from 'react'
import { Modal } from 'antd'
import './styles.scss'

export default class ErrorBoundary extends React.Component {
  state = { hasError: false, error: null, tipText: null }

  componentDidCatch(error, info) {
    console.error(error, info)
    logger.error('react error', JSON.stringify({ error, info }))

    if (
      error &&
      (error.toString().indexOf('ChunkLoadError') === 0 ||
        error.toString().indexOf('Error: Loading CSS ') === 0)
    ) {
      // 监测到Webpack异步模块加载失败
      Modal.confirm({
        title: '检测到网站可能有更新,需要刷新页面',
        okText: '刷新',
        cancelText: '关闭',
        maskClosable: false,
        onOk: () => {
          location.reload()
        },
      })
      this.setState({ hasError: true, tipText: '网站可能有更新,请刷新页面' })
    } else {
      this.setState({ hasError: true, error, tipText: null })
    }
  }

  render() {
    if (this.state.tipText) {
      return (
        <div className='page-error page-standard'>
          <h2 className='title'>{this.state.tipText}</h2>
        </div>
      )
    } else if (this.state.hasError) {
      return (
        <div className='page-error page-standard'>
          <h2 className='title'>抱歉,页面出错</h2>
          <h5 className='tip'>请尝试刷新页面,或联系技术人员,以下是错误信息:</h5>
          <div className='error-message'>
            {this.state.error ? this.state.error.toString() : '错误:未知错误'}
          </div>
        </div>
      )
    }

    return this.props.children
  }
}

// 使用案例:启动入口页面包裹(React 18+ 用 createRoot,ReactDOM.render 已在 React 19 中移除)
import React from 'react'
import { createRoot } from 'react-dom/client'
import ErrorBoundary from 'components/ErrorBoundary'

const appRoot = document.getElementById('root')
appRoot.setAttribute('translate', 'no')

createRoot(appRoot).render(<ErrorBoundary>{/* code... */}</ErrorBoundary>)
React 的错误处理还有几点要注意:
- 错误边界到现在仍然只能用 class 组件写,业务里一般直接用
react-error-boundary库(提供<ErrorBoundary fallbackRender>和useErrorBoundary)。 - 错误边界捕获不到事件处理函数、异步代码(setTimeout、Promise)里的错误,这些仍需要 try/catch 或全局监听兜底。
- React 19 的
createRoot(el, { onCaughtError, onUncaughtError, onRecoverableError })可以统一接管上报,不用在每个错误边界里各自上报。 - Webpack / Vite 的 chunk 加载失败(发版后旧页面请求已删除的文件)是很常见的线上错误:Webpack 抛
ChunkLoadError,Vite 会派发vite:preloadError事件,可以在里面location.reload()。
延伸: 跨域的 js 运行错误可以捕获吗,错误提示什么,应该怎么处理?
跨域之后 window.onerror 是无法捕获异常信息的,所以统一返回 Script error,解决方案
- 在 script 标签增加 crossorigin="anonymous" 属性
- 脚本所在服务器(CDN)的响应头设置 Access-Control-Allow-Origin: *(或具体的源)
两步缺一不可:只加属性不配响应头,脚本会直接因为 CORS 加载失败。
17.3 监控平台搭建
这个应该每个公司都有自己的监控平台,这里不列举过多。
如果数据量过大,架构需要对行为记录存储的设计与成本进行考虑。如容器存储与存放时间等
17.3.1 数据监控
- PV:即页面浏览量或点击量
- UV:指访问某个站点的独立访客数,现在一般按设备 ID / 用户 ID 去重,而不是按 IP
- 页面停留时长
- 用户与数据来源
- 触发行为
17.3.2 性能监控
- 不同环境下机型与系统下的首屏加载时间
- DNS、TCP、request、页面渲染、load、加载、白屏等耗时时间
- Core Web Vitals(LCP / INP / CLS)、长任务(Long Tasks / Long Animation Frames)
17.3.3 异常监控
JavaScript与样式异常
17.4 埋点
数据上报可以在延伸扩展:即时,批量,主动等上报方式,可根据业务优先级来决定
代码埋点与数据上报
埋点方式一般分三种:代码埋点(精确,但要开发介入)、可视化埋点(运营在后台圈选元素)、无埋点 / 全埋点(自动采集所有点击,再在后台筛选)。
上报通道推荐用 navigator.sendBeacon(url, data):页面关闭时也能可靠发出,不阻塞卸载。时机选在 visibilitychange(document.visibilityState === 'hidden')而不是 unload / beforeunload,后两者在移动端经常不触发,还会让页面无法进入 bfcache。另一种常见方式是 1x1 的 GIF 图片请求,天然跨域且不阻塞。
自研监控平台的公司变少了,更多直接用 Sentry(错误 + 性能 + Session Replay,可以自托管)或云厂商的 RUM 服务,后端链路追踪则统一到 OpenTelemetry。上报时别忘了上传 source map(但不要部署到线上公开访问),否则拿到的都是压缩后的行列号。
flowchart TD
  subgraph PV[页面访问量统计]
    E([进入页面]) --> D1[用户设备] & D2[访问信息,统计 PV / UV] & D3[分析耗时,Performance API] & D4[用户来源]
  end
  subgraph ERR[异常统计]
    X([页面异常]) --> X1[根据对应报错进行捕获和上报]
  end
  subgraph FN[功能点击量统计]
    F([功能统计]) --> F1[类型] & F2[上报数据源]
    F1 --> F3[业务类型] & F4[无类型]
  end
  PV --> S[服务端接收数据并处理分析]
  ERR --> S
  FN --> S
  S --> K[ES + Kafka]
十八、Node.js
Node 的事件循环见 NodeJs。
18.1 进程与线程
Node 主线程只有一个,CPU 密集任务会阻塞事件循环,所以要会用多进程和多线程。
18.1.1 开启进程的方法
child_process 模块提供四个方法:
spawn:最底层,以流的方式返回输出,适合长时间运行、输出量大的命令exec:起一个 shell 执行命令,输出缓存后一次性回调,有大小限制,拼接用户输入有命令注入风险execFile:直接执行可执行文件,不经过 shell,更安全fork:spawn的特例,专门启动新的 Node 进程并建立 IPC 通道
Node.js 通过提供 cluster、child_process API 创建子进程的方式来赋予Node.js “多线程”能力。但是这种创建进程的方式会牺牲共享内存,并且数据通信必须通过json进行传输。(有一定的局限性和性能问题) 基于此 Node.js V10.5.0 提供了 worker_threads,它比 child_process 或 cluster更轻量级。 与child_process 或 cluster 不同,worker_threads 可以共享内存,通过传输 ArrayBuffer 实例或共享 SharedArrayBuffer 实例来实现。
18.1.2 进程之间如何通讯
child_process.fork()创建的子进程自带 IPC 通道:父进程child.send(msg)/child.on('message'),子进程process.send(msg)/process.on('message');cluster模块底层就是 forkworker_threads之间用postMessage/MessageChannel,还可以通过SharedArrayBuffer+Atomics共享内存- 通用方式:stdin / stdout 管道、Unix domain socket / TCP、借助 Redis 等消息中间件(多机部署时只能这样)
18.2 错误处理
大多数异步API发生错误,采用callback方式来处理异常,其中callback的第一个参数就是err,如果第一个参数为null,而非err的话,则正确执行后面指令,反之为error的话,就会处理相应错误。
现在的写法更多是:
- Promise 版 API(
fs/promises等)+async/await+try/catch - EventEmitter(stream、socket)要监听
'error'事件,否则错误会直接抛出导致进程退出 - 全局兜底:
process.on('uncaughtException')、process.on('unhandledRejection'),只用来记录日志后退出进程,由 pm2 / k8s 拉起,不要吞掉错误继续运行 - Node 15 起未处理的 Promise rejection 默认会让进程崩溃
18.3 部署
pm2,docker容器化等。pm2 负责进程守护、cluster 模式多核负载、日志和零停机重载;容器化后通常交给 Kubernetes 管理副本和滚动发布,前面用 nginx 或网关做反向代理和 HTTPS 终结。不需要长驻进程的服务也可以部署成 Serverless 函数或边缘函数(Vercel、Cloudflare Workers)。
18.4 现在的 Node
- 版本节奏:偶数版本是 LTS,生产环境用当前的 Active LTS。
- 内置能力越来越多:
fetch、WebSocket客户端、node:test测试框架、--watch、--env-file、node:sqlite,很多以前要装依赖的场景现在直接用内置模块。 - 原生跑 TypeScript:Node 22.18 / 23.6 起默认支持类型擦除(type stripping),可以直接
node app.ts,前提是只用可擦除的语法(不能用enum、namespace、参数属性,可以开 TS 的erasableSyntaxOnly检查)。 require(esm):Node 22.12 / 20.19 起可以直接require()同步的 ES 模块,CJS 和 ESM 混用的痛点小了很多。- 其他运行时:Bun(自带打包、测试、包管理,启动快)和 Deno 2(兼容 npm,默认安全沙箱)也能跑大部分 Node 代码;边缘运行时(Cloudflare Workers 等)只提供 Web 标准 API 的子集,见 边缘计算。
十九、工程化
工程化相关的基础设施(Docker、Nginx、PM2、私有 npm、版本管理)见 前端工程化与运维,Webpack 的配置和原理见 Webpack 学习总结。这里只整理面试常问的部分。
19.1 模块化
- 功能分治,利维护
- 复用,利开发
- 隔离作用域,避免全局变量污染和命名冲突
- 显式声明依赖,便于构建工具分析(tree shaking、代码分割)
演进过程:全局变量 / IIFE → CommonJS(Node,同步 require)、AMD(RequireJS,浏览器异步加载)、UMD(兼容两者)→ ES Module(语言标准)。
CommonJS 和 ESM 的核心区别:CJS 运行时加载,导出的是值的拷贝,可以动态 require;ESM 编译时静态分析,导出的是实时绑定(live binding),顶层 this 是 undefined,支持顶层 await。现在浏览器和 Node 都原生支持 ESM,新库一般只发 ESM;Node 22.12 / 20.19 起可以直接 require() 同步的 ESM 模块,两套模块系统的互操作问题缓和了很多。
19.1.1 包的 exports 字段与双包问题
现代 npm 包用 package.json 的 exports 字段声明入口,它优先级高于 main,而且会封装包内部路径:没在 exports 里列出的文件,使用方无法直接 import。
{
  "name": "my-lib",
  "type": "module",
  "exports": {
    ".": {
      "types": "./dist/index.d.ts",
      "import": "./dist/index.js",
      "require": "./dist/index.cjs"
    },
    "./utils": "./dist/utils.js"
  }
}
同时发布 ESM 和 CJS 两份产物时,有双包问题(dual package hazard):同一个应用里一部分代码 import、一部分 require,会加载两份互相独立的模块实例,单例、instanceof 判断都会出错。解决方法是只发 ESM(Node 已支持 require(esm)),或者让 CJS 入口只是 ESM 实现的薄包装。
19.2 构建工具
19.2.1 Webpack
- 优化:分构建速度和产物体积两方面:持久化缓存(
cache: { type: 'filesystem' })、缩小 loader 处理范围、splitChunks拆包、tree shaking、动态import()懒加载、压缩、externals 等。详见 Webpack 学习总结 · 五、Webpack 优化配置。 - 依赖查找:构建时:从 entry 开始,用
enhanced-resolve按resolve配置(alias、extensions、modules、package.json 的exports/main字段)把路径解析成绝对路径,跑完 loader 后用 AST 分析出新的依赖,递归下去得到模块图。运行时:产物里每个模块被包成函数放进模块表,__webpack_require__(moduleId)先查模块缓存,没有就执行对应函数并缓存module.exports。详见 Webpack 学习总结的 8.5 make 和 8.7 产物里的 runtime。 - 动态加载:遇到
import()时,webpack 把被引入的模块拆成单独的 chunk。运行时调用__webpack_require__.e(chunkId):动态创建<script>去加载 chunk 文件并返回 Promise;chunk 文件执行时把自己的模块推进全局数组(webpackChunk<name>.push),被 runtime 拦截后注册到模块表并 resolve 那个 Promise,之后再用__webpack_require__取出模块。
插件原理:
webpack 基于 Tapable 实现了一套事件钩子,Compiler 和 Compilation 在构建的各个阶段触发对应钩子。插件就是一个带 apply(compiler) 方法的类,在 apply 里往需要的钩子上注册回调,从而在特定时机读取或修改构建过程和产物:
class FileListPlugin {
  apply(compiler) {
    compiler.hooks.thisCompilation.tap('FileListPlugin', (compilation) => {
      compilation.hooks.processAssets.tap(
        { name: 'FileListPlugin', stage: compilation.constructor.PROCESS_ASSETS_STAGE_SUMMARIZE },
        (assets) => {
          const list = Object.keys(assets).join('\n')
          compilation.emitAsset('filelist.md', new compiler.webpack.sources.RawSource(list))
        }
      )
    })
  }
}
详见 Webpack 学习总结的 8.1 Tapable 和 8.10 自定义 Plugin。
19.2.2 Vite 与新一代工具链
Vite 的核心思路:
- 开发时不打包:利用浏览器原生 ESM,请求哪个模块就按需编译哪个,启动时间和项目大小基本无关;依赖用 esbuild 预构建,把大量小文件的 CJS 包转成一个 ESM 文件。
- HMR 精确到模块:只让改动模块和它的 HMR 边界失效,不重新打包。
- 生产构建用 Rollup 风格的打包:浏览器原生 ESM 在生产环境请求太多,仍需要打包、tree shaking 和代码分割。
开发和生产用两套工具,会带来行为不一致,所以 Vite 正在把底层统一换成 Rust 写的 Rolldown(兼容 Rollup API),并基于 oxc 做解析和转换。
其他选择:
- Rspack:Rust 实现,兼容大部分 Webpack 配置和插件,适合存量 Webpack 项目平滑提速。
- Turbopack:Next.js 的默认打包器(Next 16 起开发和构建都默认使用)。
- esbuild / SWC / oxc:负责转译和压缩的底层工具,通常被上层工具集成,不直接面对业务。
面试常问「为什么 Vite 开发快」「Webpack 和 Vite 怎么选」:新项目默认 Vite(或框架自带的工具链);大型 Webpack 存量项目先考虑迁移到 Rspack,改动最小。
19.3 Monorepo
多个包放在一个仓库里,共享依赖和工具链,跨包修改可以一次提交、一次评审。
- 包管理:pnpm workspace 是主流。pnpm 用内容寻址存储 + 硬链接,磁盘占用小;
node_modules是严格的非扁平结构,能避免「幽灵依赖」(没在 package.json 里声明却能 import 到)。 - 任务编排:Turborepo 或 Nx,按依赖拓扑并行执行任务,并缓存构建结果(本地和远程),没改动的包直接命中缓存。
- 版本发布:changesets,每次改动附带一个变更说明文件,发版时自动计算版本号、生成 changelog。
- 包边界:内部包通过
exports暴露公开 API,用workspace:*协议相互依赖;用 lint 规则禁止跨包引用内部文件。
19.4 代码质量
- Lint 和格式化:ESLint 9 起默认使用 flat config(
eslint.config.js);Biome 和 oxlint 用 Rust 实现,一个工具同时做 lint 和格式化,速度快几十倍,新项目越来越常用。 - 测试分层:单元测试用 Vitest(和 Vite 共用配置,API 兼容 Jest);组件测试用 Testing Library,按用户视角查询元素(
getByRole)而不是依赖实现细节;E2E 用 Playwright,支持多浏览器和自动等待。 - 类型检查:CI 里单独跑
tsc --noEmit(Vite、esbuild 只做类型擦除,不检查类型)。 - 提交前检查:husky / lefthook + lint-staged,只检查改动的文件。
19.5 CI/CD
一条典型的流水线:安装依赖(带缓存)→ lint、类型检查、单元测试 → 构建 → E2E → 部署预览环境(每个 PR 一个独立地址,方便评审)→ 合并后发布到生产,支持灰度和一键回滚。
前端产物的发布要注意:先上传带 hash 的静态资源,再更新 HTML 入口,避免用户拿到新 HTML 却请求不到新资源;旧版本资源保留一段时间,给还开着旧页面的用户使用。
二十、其他
20.1 无障碍(a11y)
- 语义化优先:按钮用
<button>,链接用<a href>,表单控件配<label>。原生元素自带键盘操作、焦点和读屏语义,用<div onClick>模拟就得自己补齐role、tabindex、键盘事件,很容易漏。 - ARIA 第一原则:能用原生元素就不用 ARIA。常见的坑:给
<button>再加role="button";aria-hidden="true"的容器里还有可聚焦元素;只有图标的按钮缺少aria-label。 - 焦点管理:弹窗打开时把焦点移进去,关闭后还回触发按钮,期间 Tab 不能跑到弹窗外(原生
<dialog>的showModal()已经处理好了);不要用outline: none去掉焦点样式,用:focus-visible只在键盘操作时显示。 - 其他:图片写
alt(装饰图写空alt="");文字和背景的对比度满足 WCAG AA(正文 4.5:1);动画尊重prefers-reduced-motion;动态更新的内容用aria-live通知读屏。 - 检查工具:Lighthouse、axe DevTools,再用键盘和系统读屏(VoiceOver、NVDA)实际操作一遍。
20.2 Web Components
由三个标准组成:Custom Elements(自定义标签和生命周期)、Shadow DOM(样式和 DOM 隔离)、<template> / <slot>。
class HelloCard extends HTMLElement {
  static observedAttributes = ['name']

  constructor() {
    super()
    this.attachShadow({ mode: 'open' })
  }

  attributeChangedCallback() {
    this.shadowRoot.innerHTML = `<style>p { color: teal; }</style><p>Hello, ${this.getAttribute('name')}</p>`
  }
}
customElements.define('hello-card', HelloCard)
// <hello-card name="wudi"></hello-card>
适用边界:
- 适合:跨框架复用的组件(设计系统、第三方嵌入的小部件),以及需要强样式隔离的场景。
- 不适合:作为应用框架。它没有响应式状态和模板更新机制,通常要配合 Lit 这类库;SSR 依赖 Declarative Shadow DOM;Shadow DOM 隔离样式的同时也让全局主题、表单关联、无障碍的 ID 引用变麻烦。
20.3 微前端
把一个大型前端应用拆成多个可以独立开发、独立部署的子应用。主流方案:
| 方案 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| iframe | 浏览器原生隔离 | 隔离最彻底、最简单 | 弹窗无法覆盖全屏、路由和状态同步麻烦、每次加载慢 |
| qiankun / single-spa | 运行时加载子应用的 JS 和 CSS,JS 沙箱 + 样式隔离 | 技术栈无关,老项目接入成本低 | 沙箱有性能开销和边界问题 |
| Module Federation | 构建时声明共享模块,运行时按需加载远程模块 | 依赖可以共享、粒度可以细到组件 | 依赖 Webpack / Rspack 体系,版本管理要小心 |
| Web Components | 子应用包装成自定义元素 | 标准化 | 见上文的局限 |
微前端解决的是组织问题(多团队独立交付),不是技术问题,团队不大时引入它往往得不偿失。qiankun 的实践见 微前端笔记。
20.4 WebAssembly
WebAssembly 是浏览器里运行的二进制指令格式,可以把 C / C++ / Rust / Go 编译成 Wasm,以接近原生的速度执行。它不是用来取代 JS 的,而是补充计算密集的部分:
- 图像、音视频处理:ffmpeg.wasm、Squoosh 的图片压缩;
- 把桌面软件搬上 Web:Figma 的渲染引擎、Photoshop Web 版、AutoCAD;
- 本地计算:浏览器里的 SQLite、加解密、端侧 AI 推理(配合 WebGPU);
- 工具链:esbuild、SWC、oxc 都有 Wasm 版本,可以在浏览器里运行。
需要注意的是,Wasm 和 JS 之间传递数据有开销,频繁的小调用可能反而更慢;它也不能直接操作 DOM。
20.5 边缘计算
边缘函数运行在 CDN 节点上,离用户近、冷启动快(通常基于 V8 isolate,而不是容器),代表有 Cloudflare Workers、Vercel / Netlify Edge Functions。它只提供 Web 标准 API 的子集(fetch、Request / Response、Web Crypto),不能使用 Node 的全部模块,单次执行有 CPU 时间限制。
和传统 BFF 的分工:
- 边缘层:做轻量、对延迟敏感的事情。鉴权和重定向、A/B 实验分流、按地区或设备返回不同内容、缓存命中前的改写、简单的 API 聚合;Next.js 的 Middleware 就跑在这一层。
- BFF / 后端服务:做重的事情。复杂的业务编排、数据库事务、长时间任务。边缘节点离数据库远,每次查询都要跨地域,反而更慢。
20.6 AI 与前端
大模型应用的前端是最近两年新增的高频考点,传输层的流式输出见 SSE。界面上常问这几类:
- 流式渲染:收到增量文本就追加显示(打字机效果)。要注意按帧合并更新,避免每个 token 都触发一次渲染;流式 Markdown 要能处理未闭合的代码块和表格;自动滚动到底部,但用户往上翻时要停止跟随。
- 可中断与重试:用
AbortController实现「停止生成」,支持重新生成和编辑后重发,处理好半截回复的展示状态。 - 工具调用和 Agent 的展示:模型调用工具(搜索、读文件、执行代码)时,把步骤、参数和结果以可折叠的卡片展示;需要用户确认的操作(发邮件、付款)必须有明确的确认环节。
- 生成式 UI:模型返回结构化数据,前端映射成组件渲染(卡片、表格、图表),而不是只显示纯文本。Vercel AI SDK 等库封装了这些模式。
- RAG 产品形态:回答中标注引用来源,点击可以跳到原文片段,让用户能核实答案。
软技能方向也常被问到:怎么用 AI 编码工具提高效率、怎么评审 AI 生成的代码(重点看边界条件、错误处理、安全问题,以及有没有引入不必要的复杂度)、怎么给 AI 提供足够的上下文(项目约定、相关代码、明确的验收标准)。
二十一、算法
前端面试的算法题难度一般不超过 LeetCode 中等,高频类型是:数组 / 字符串(双指针、滑动窗口)、哈希表、链表、二叉树遍历(DFS / BFS)、栈和队列、简单动态规划。外加大量「手写题」:防抖节流、深拷贝、Promise 并发控制、Promise.all、发布订阅、LRU 缓存、数组扁平化等,本文最后一节整理了一部分。
21.1 LeetCode
- LeetCode 热题 100:按题型分好类,刷完基本覆盖前端面试的算法范围
21.2 排序
需要会手写快速排序和归并排序,知道各自的时间复杂度和稳定性:
| 算法 | 平均时间 | 最坏时间 | 空间 | 稳定 |
|---|---|---|---|---|
| 冒泡 / 插入 | O(n²) | O(n²) | O(1) | 是 |
| 选择 | O(n²) | O(n²) | O(1) | 否 |
| 快速排序 | O(n log n) | O(n²) | O(log n) | 否 |
| 归并排序 | O(n log n) | O(n log n) | O(n) | 是 |
| 堆排序 | O(n log n) | O(n log n) | O(1) | 否 |
V8 的 Array.prototype.sort 从 7.0(Chrome 70)起改用 TimSort,是稳定排序(ES2019 起规范也要求稳定)。
10 种排序的实现见 数据结构与算法 · 排序。
21.3 堆栈,队列,链表
- 栈:后进先出,典型应用是函数调用栈、括号匹配、撤销 / 重做、表达式求值
- 队列:先进先出,典型应用是任务调度、BFS、消息队列;JS 事件循环的任务队列也是队列
- 链表:插入删除 O(1)、按下标访问 O(n),和数组的对比见下表;高频题是反转链表、环形链表检测、合并有序链表
链表和数组的区别:
| 数组 | 链表 | |
|---|---|---|
| 内存 | 连续 | 不连续,节点通过指针相连 |
| 按下标访问 | O(1) | O(n),要从头遍历 |
| 插入 / 删除 | O(n),需要移动后面的元素 | 已知节点时 O(1),只改指针 |
| 额外空间 | 无 | 每个节点要存指针 |
| 缓存友好 | 是 | 否 |
读多写少用数组,频繁在中间插入删除用链表。JS 的数组是动态的,V8 会根据内容在连续存储和哈希表存储之间切换。React Fiber 树就是用链表(child / sibling / return 指针)实现的,所以遍历可以随时中断和恢复。
21.4 递归
- 两个要素:终止条件 + 递推关系
- 递归过深会爆栈(Node 24 下一个空函数大约 1.2 万层),而 V8 并没有实现尾调用优化,深度不可控时要用显式栈改成迭代
- 子问题重叠时用记忆化或改成动态规划,避免指数级的重复计算
- 前端常考:深拷贝(处理循环引用)、数组扁平化、树形结构遍历 / 转换(如列表转树)、全排列
详细说明和斐波那契、扁平化、深拷贝的代码见 数据结构与算法 · 递归。
21.5 波兰式和逆波兰式
- 波兰式(前缀):
* + 2 1 3;逆波兰式(后缀):2 1 + 3 *;对应中缀(2 + 1) * 3 - 前缀和后缀不需要括号和优先级,用一个栈扫描一遍就能求值,这是栈的经典应用(LeetCode 150. 逆波兰表达式求值)
- 中缀转后缀用调度场算法(shunting-yard)
求值和转换的代码见 数据结构与算法 · 表达式求值。
二十二、写在最后
五年过去,基础题大部分还在,变化主要在追问的方向,这次修订也是按这个思路补的:
- 考察重心变了:IE 兼容、雪碧图、JSONP 这类题基本消失;TypeScript、React 19 和 Server Components、Vue 3 响应式、Core Web Vitals 成了高频题,对应本文的 TypeScript、框架与元框架 和 页面性能。
- 工程化成了默认要求:Vite / Rspack、monorepo、测试和 CI/CD 会被当作中高级岗位的基本功来问,见 工程化。
- AI 进入日常开发:既会问大模型应用的前端实现(流式输出、可中断、工具调用展示),也会问怎么用好、评审好 AI 写的代码,见 AI 与前端。
不变的是开头那句话:面试题只是一个引子,背答案不如把每道题背后的原理弄清楚。附录里的手写题和易错点,适合面试前集中过一遍。
附录 A:高频手写题
按出现频率整理,代码都可以直接在 Node 里运行。和专题强相关的几道题放在对应章节里:new 见 new 运算符,instanceof 见 instanceof,继承见 组合继承 - 优化2,深拷贝和数组扁平化见 数据结构与算法 · 递归。
A.1 call、apply、bind
// call:把函数临时挂到 thisArg 上调用,用 Symbol 做 key 避免覆盖已有属性
Function.prototype.myCall = function (thisArg, ...args) {
  // null / undefined 时指向全局对象(非严格模式语义),原始值要先包装成对象
  const ctx = thisArg == null ? globalThis : Object(thisArg)
  const key = Symbol('fn')
  ctx[key] = this
  const result = ctx[key](...args)
  delete ctx[key]
  return result
}

// apply:和 call 一样,只是参数以数组传入
Function.prototype.myApply = function (thisArg, args = []) {
  return this.myCall(thisArg, ...args)
}

function greet(greeting, mark) {
  return `${greeting}, ${this.name}${mark}`
}
console.log(greet.myCall({ name: 'wudi' }, 'Hi', '!')) // Hi, wudi!
console.log(greet.myApply({ name: 'wudi' }, ['Hello', '?'])) // Hello, wudi?
// bind
// 箭头函数的 this 永远指向它所在的作用域
// 函数作为构造函数用 new 关键字调用时,不应该改变其 this 指向,因为 new绑定 的优先级高于 显示绑定 和 硬绑定
Function.prototype.mybind = function (thisArg, ...presetArgs) {
if (typeof this !== 'function') {
throw new TypeError('绑定必须在函数上调用')
}
// 保存原函数
const fn = this
// 绑定的函数
const bound = function (...args) {
// new.target 存在说明是用 new 调用的 bound,此时 this 是新实例,不能改成 thisArg
if (new.target) {
return Reflect.construct(fn, [...presetArgs, ...args], new.target)
}
return fn.apply(thisArg, [...presetArgs, ...args])
}
// 箭头函数处理:由于箭头函数没有 prototype,箭头函数this永远指向它所在的作用域
if (fn.prototype) {
// 让 new bound() 得到的实例能访问原函数原型上的属性
bound.prototype = Object.create(fn.prototype)
}
return bound
}
// 测试
const bar = function (...args) {
console.log(this.name, args)
}
bar.prototype.name = 'bar'
const foo = { name: 'foo' }
const bound = bar.mybind(foo, 22, 33)
new bound(44) // bar [22, 33, 44]
bound(44) // foo [22, 33, 44]A.2 数组 reduce
// reduce
Array.prototype.myReduce = function (callback, ...rest) {
  if (typeof callback !== 'function') {
    throw new TypeError(`${callback} is not a function`)
  }
  const arr = this
  let i = 0
  let acc
  if (rest.length > 0) {
    acc = rest[0]
  } else {
    // 没传初始值时,用第一个存在的元素作为初始值(跳过稀疏数组的空位)
    while (i < arr.length && !(i in arr)) i++
    if (i >= arr.length) {
      throw new TypeError('Reduce of empty array with no initial value')
    }
    acc = arr[i++]
  }
  for (; i < arr.length; i++) {
    if (i in arr) acc = callback(acc, arr[i], i, arr)
  }
  return acc
}

console.log([1, 2, 3].myReduce((a, b) => a + b)) // 6
console.log([1, 2, 3].myReduce((a, b) => a + b, 10)) // 16
A.3 Promise 静态方法
// Promise.all:全部成功才成功,按输入顺序返回结果;任意一个失败立即失败
Promise.myAll = function (iterable) {
  return new Promise((resolve, reject) => {
    const items = Array.from(iterable)
    const results = new Array(items.length)
    let done = 0
    if (items.length === 0) return resolve(results)
    items.forEach((item, i) => {
      // 用 Promise.resolve 包一层,兼容非 Promise 的值
      Promise.resolve(item).then((value) => {
        results[i] = value
        if (++done === items.length) resolve(results)
      }, reject)
    })
  })
}

// Promise.allSettled:等全部结束,不管成功失败
Promise.myAllSettled = function (iterable) {
  return Promise.myAll(
    Array.from(iterable, (item) =>
      Promise.resolve(item).then(
        (value) => ({ status: 'fulfilled', value }),
        (reason) => ({ status: 'rejected', reason }),
      ),
    ),
  )
}

// Promise.race:谁先结束(成功或失败)就用谁的结果
Promise.myRace = function (iterable) {
  return new Promise((resolve, reject) => {
    for (const item of iterable) Promise.resolve(item).then(resolve, reject)
  })
}

// Promise.any:任意一个成功就成功;全部失败才失败,抛 AggregateError
Promise.myAny = function (iterable) {
  return new Promise((resolve, reject) => {
    const items = Array.from(iterable)
    const errors = new Array(items.length)
    let failed = 0
    if (items.length === 0) return reject(new AggregateError([], 'All promises were rejected'))
    items.forEach((item, i) => {
      Promise.resolve(item).then(resolve, (reason) => {
        errors[i] = reason
        if (++failed === items.length) reject(new AggregateError(errors, 'All promises were rejected'))
      })
    })
  })
}

const ok = (v, ms) => new Promise((r) => setTimeout(() => r(v), ms))
const fail = (e, ms) => new Promise((_, r) => setTimeout(() => r(e), ms))
await Promise.myAll([ok(1, 30), 2, ok(3, 10)]).then(console.log) // [1, 2, 3]
await Promise.myAll([ok(1, 30), fail('x', 10)]).catch(console.log) // x
await Promise.myAllSettled([ok(1, 10), fail('x', 5)]).then((r) => console.log(JSON.stringify(r)))
// [{"status":"fulfilled","value":1},{"status":"rejected","reason":"x"}]
await Promise.myRace([ok('slow', 30), ok('fast', 10)]).then(console.log) // fast
await Promise.myAny([fail('a', 5), ok('b', 20)]).then(console.log) // b
await Promise.myAny([fail('a', 5), fail('b', 10)]).catch((e) => console.log(e.constructor.name, e.errors)) // AggregateError [ 'a', 'b' ]
A.4 简版 Promise
面试一般不要求完整实现 Promises/A+,但要能写出状态机、回调队列、then 链式调用和值穿透这几个核心点。下面这个版本跑过 promises-aplus-tests 的全部 872 个用例:
// 简版 Promise:状态机 + 回调队列 + then 链式调用
class MyPromise {
  #state = 'pending'
  #value = undefined
  #callbacks = []

  constructor(executor) {
    const settle = (state, value) => {
      if (this.#state !== 'pending') return // 状态只能改变一次
      this.#state = state
      this.#value = value
      this.#callbacks.forEach((cb) => cb())
    }
    const resolve = (value) => {
      if (value === this) return settle('rejected', new TypeError('Chaining cycle detected'))
      // resolve 一个 thenable(包括 Promise)时,要跟随它的最终状态
      if (value !== null && (typeof value === 'object' || typeof value === 'function')) {
        let then
        try {
          then = value.then
        } catch (e) {
          return settle('rejected', e)
        }
        if (typeof then === 'function') {
          let called = false
          try {
            then.call(
              value,
              (v) => !called && ((called = true), resolve(v)),
              (e) => !called && ((called = true), settle('rejected', e)),
            )
          } catch (e) {
            if (!called) settle('rejected', e)
          }
          return
        }
      }
      settle('fulfilled', value)
    }
    try {
      executor(resolve, (reason) => settle('rejected', reason))
    } catch (e) {
      settle('rejected', e)
    }
  }

  then(onFulfilled, onRejected) {
    return new MyPromise((resolve, reject) => {
      const run = () => {
        // 回调必须异步执行,规范要求放进微任务
        queueMicrotask(() => {
          const handler = this.#state === 'fulfilled' ? onFulfilled : onRejected
          // 没传对应回调时值 / 错误继续向后传递(值穿透)
          if (typeof handler !== 'function') {
            return this.#state === 'fulfilled' ? resolve(this.#value) : reject(this.#value)
          }
          try {
            resolve(handler(this.#value))
          } catch (e) {
            reject(e)
          }
        })
      }
      if (this.#state === 'pending') this.#callbacks.push(run)
      else run()
    })
  }

  catch(onRejected) {
    return this.then(undefined, onRejected)
  }

  finally(onFinally) {
    return this.then(
      (value) => MyPromise.resolve(onFinally()).then(() => value),
      (reason) =>
        MyPromise.resolve(onFinally()).then(() => {
          throw reason
        }),
    )
  }

  static resolve(value) {
    return value instanceof MyPromise ? value : new MyPromise((resolve) => resolve(value))
  }

  static reject(reason) {
    return new MyPromise((_, reject) => reject(reason))
  }
}

new MyPromise((resolve) => setTimeout(() => resolve(1), 10))
  .then((v) => v + 1)
  .then((v) => new MyPromise((resolve) => resolve(v * 10))) // 返回 Promise 会被展开
  .then()
  .then((v) => {
    console.log(v) // 20
    throw new Error('boom')
  })
  .catch((e) => console.log(e.message)) // boom
  .finally(() => console.log('finally')) // finally

console.log('sync') // 先输出 sync:then 回调总是异步执行
A.5 Promise 并发控制
思路:同时启动 max 个 worker,每个 worker 循环从任务队列里取下一个任务执行,直到队列取空。
async function limitRun(tasks, max) {
  const results = []
  let index = 0
  // 起 max 个 worker,每个 worker 不断从队列里取下一个任务
  async function worker() {
    while (index < tasks.length) {
      const i = index++
      results[i] = await tasks[i]()
    }
  }
  await Promise.all(Array.from({ length: Math.min(max, tasks.length) }, worker))
  return results
}

// 用法:tasks 是返回 Promise 的函数数组
const sleep = (ms, v) => () => new Promise((r) => setTimeout(() => r(v), ms))
limitRun([sleep(300, 1), sleep(100, 2), sleep(200, 3)], 2).then(console.log) // [1, 2, 3]
实际项目可以直接用 p-limit。
A.6 防抖节流
/**
 * @description 函数防抖:连续触发时,只在停止触发 wait 毫秒后执行一次
 * @param {Function} method 延时调用函数
 * @param {Number} wait 延迟时长
 * @param {Boolean} immediate 立即执行选项:第一次触发立即执行,之后 wait 毫秒内不再执行
 */
export function debounce<T extends (...args: any[]) => void>(
  method: T,
  wait: number,
  immediate = false
) {
  if (typeof method !== 'function') {
    throw new TypeError('Expected a function')
  }
  let timeout: ReturnType<typeof setTimeout> | null = null

  // 用普通函数而不是箭头函数,才能拿到调用时的 this
  function debounced(this: ThisParameterType<T>, ...args: Parameters<T>) {
    // 如果存在定时器则将其清除
    if (timeout) clearTimeout(timeout)

    if (immediate) {
      // 定时器不存在,说明是一轮触发的第一次,立即执行
      const callNow = !timeout
      // wait 毫秒后将定时器置为 null,确保立即执行后 wait 毫秒内不会被再次触发
      timeout = setTimeout(() => {
        timeout = null
      }, wait)
      if (callNow) method.apply(this, args)
    } else {
      timeout = setTimeout(() => {
        timeout = null
        method.apply(this, args)
      }, wait)
    }
  }

  // 取消方法
  debounced.cancel = () => {
    if (timeout) clearTimeout(timeout)
    timeout = null
  }

  return debounced
}
/**
* 节流:连续触发时,每 delay 毫秒最多执行一次
* @param func 回调函数
* @param delay 延迟时间
*/
export function throttle<T extends (...args: any[]) => void>(func: T, delay: number) {
let timer: ReturnType<typeof setTimeout> | null = null
return function (this: ThisParameterType<T>, ...args: Parameters<T>) {
if (!timer) {
timer = setTimeout(() => {
func.apply(this, args)
timer = null
}, delay)
}
}
}原来的防抖实现把防抖函数包成了返回 Promise 的 async 函数,有两个问题:被后续调用打断的那些 Promise 永远不会 resolve,调用方 await 会一直挂起;而且外层用的是箭头函数,this 并不是调用时的 this。现在改成了上面这个常规写法。需要拿到返回值、需要 maxWait 或 leading / trailing 选项时,直接用 lodash-es 的 debounce / throttle。
另外上面的节流是「定时器版」(第一次触发要等 delay 后才执行);「时间戳版」是第一次立即执行。滚动、动画相关的节流可以直接用 requestAnimationFrame,每帧最多执行一次。
A.7 发布订阅
class EventEmitter {
  #events = new Map() // eventName -> Set<listener>

  on(name, listener) {
    if (!this.#events.has(name)) this.#events.set(name, new Set())
    this.#events.get(name).add(listener)
    return () => this.off(name, listener) // 返回取消订阅函数,方便在组件卸载时调用
  }

  once(name, listener) {
    const wrapper = (...args) => {
      this.off(name, wrapper)
      listener.apply(this, args)
    }
    return this.on(name, wrapper)
  }

  off(name, listener) {
    this.#events.get(name)?.delete(listener)
  }

  emit(name, ...args) {
    // 复制一份再遍历,避免回调里 off / once 修改集合影响本轮触发
    for (const listener of [...(this.#events.get(name) ?? [])]) listener.apply(this, args)
  }
}

const bus = new EventEmitter()
const off = bus.on('msg', (v) => console.log('on', v))
bus.once('msg', (v) => console.log('once', v))
bus.emit('msg', 1) // on 1, once 1
bus.emit('msg', 2) // on 2
off()
bus.emit('msg', 3) // 没有输出
和观察者模式的区别:观察者模式里目标直接持有观察者列表;发布订阅中间多了一个事件中心,发布者和订阅者互相不知道对方。更多模式见 设计模式。
A.8 LRU 缓存
// LRU 缓存:Map 会记住插入顺序,最久未使用的就是第一个 key
class LRUCache {
  #capacity
  #map = new Map()

  constructor(capacity) {
    this.#capacity = capacity
  }

  get(key) {
    if (!this.#map.has(key)) return -1
    const value = this.#map.get(key)
    // 删掉再插入,移到「最近使用」的末尾
    this.#map.delete(key)
    this.#map.set(key, value)
    return value
  }

  put(key, value) {
    this.#map.delete(key)
    this.#map.set(key, value)
    if (this.#map.size > this.#capacity) {
      // 淘汰最久未使用的,即 Map 的第一个 key
      this.#map.delete(this.#map.keys().next().value)
    }
  }
}

const cache = new LRUCache(2)
cache.put(1, 1)
cache.put(2, 2)
cache.get(1) // 1,此时 2 变成最久未使用
cache.put(3, 3) // 容量超了,淘汰 2
console.log(cache.get(2)) // -1
console.log(cache.get(3)) // 3
A.9 列表转树
// 列表转树:一次遍历 + Map 索引,O(n)
function listToTree(list, rootId = null) {
  const map = new Map(list.map((item) => [item.id, { ...item, children: [] }]))
  const roots = []
  for (const node of map.values()) {
    const parent = map.get(node.parentId)
    if (node.parentId === rootId || !parent) roots.push(node)
    else parent.children.push(node)
  }
  return roots
}

// 树转列表:DFS,去掉 children
function treeToList(tree) {
  return tree.flatMap(({ children = [], ...node }) => [node, ...treeToList(children)])
}

const list = [
  { id: 1, parentId: null, name: '前端' },
  { id: 2, parentId: 1, name: 'React' },
  { id: 3, parentId: 1, name: 'Vue' },
  { id: 4, parentId: 2, name: 'Hooks' },
]
const tree = listToTree(list)
console.log(JSON.stringify(tree))
// [{"id":1,...,"children":[{"id":2,...,"children":[{"id":4,...}]},{"id":3,...}]}]
console.log(treeToList(tree).map((n) => n.id)) // [1, 2, 4, 3]
A.10 树的最大层数与最大宽度
用 BFS 按层遍历,一次循环同时得到层数和每层节点数(「某层最多的节点数」理解为节点最多的那一层有多少个节点,也就是树的最大宽度):
// 节点结构:{ value, children: [] }
function levelStats(root) {
  if (!root) return { depth: 0, maxWidth: 0 }
  let depth = 0
  let maxWidth = 0
  let queue = [root]
  while (queue.length) {
    depth++
    maxWidth = Math.max(maxWidth, queue.length)
    // 下一层
    queue = queue.flatMap((node) => node.children ?? [])
  }
  return { depth, maxWidth }
}

const tree = { value: 1, children: [{ value: 2, children: [{ value: 4 }, { value: 5 }, { value: 6 }] }, { value: 3 }] }
console.log(levelStats(tree)) // { depth: 3, maxWidth: 3 }

// 只求深度时 DFS 递归更短
const maxDepth = (node) => (node ? 1 + Math.max(0, ...(node.children ?? []).map(maxDepth)) : 0)
console.log(maxDepth(tree)) // 3
A.11 compose 与 pipe
// compose:从右往左执行,compose(f, g)(x) === f(g(x)),Redux 中间件就是这样组合的
const compose = (...fns) => (x) => fns.reduceRight((acc, fn) => fn(acc), x)
// pipe:从左往右执行,可读性更好
const pipe = (...fns) => (x) => fns.reduce((acc, fn) => fn(acc), x)

const add1 = (x) => x + 1
const double = (x) => x * 2
console.log(compose(add1, double)(5)) // 11,先 double 再 add1
console.log(pipe(add1, double)(5)) // 12,先 add1 再 double

// 异步版(Koa 中间件的洋葱模型是另一种组合方式,见 koa-compose)
const pipeAsync = (...fns) => (x) => fns.reduce((acc, fn) => acc.then(fn), Promise.resolve(x))
pipeAsync(add1, async (x) => x * 3)(1).then(console.log) // 6
A.12 时针与分针夹角(Tencent)
function angle(h, m) {
  if (h < 24 && m < 60) {
    // 时针一小时30度,一分钟0.5度
    const a = (h % 12) * 30 + m * 0.5
    // 分针一分钟6度
    const b = m * 6
    const diff = Math.abs(a - b)
    // 夹角取较小的那个,不超过 180 度
    return Math.min(diff, 360 - diff)
  }
}

console.log(angle(9, 0)) // 90
console.log(angle(3, 30)) // 75
附录 B:易错点速查
B.1 隐式转换
三种转换规则:
| 值 | 转字符串 String() | 转数字 Number() | 转布尔 Boolean() |
|---|---|---|---|
null | 'null' | 0 | false |
undefined | 'undefined' | NaN | false |
true / false | 'true' / 'false' | 1 / 0 | - |
'' | '' | 0 | false |
'10' | - | 10 | true |
'10a' | - | NaN | true |
0 / NaN | '0' / 'NaN' | - | false |
[] | '' | 0 | true |
[1, 2] | '1,2' | NaN | true |
[null] | '' | 0 | true |
{} | '[object Object]' | NaN | true |
- 假值只有 8 个:
false、null、undefined、''、0、-0、0n、NaN,空数组和空对象都是真值。 - 对象转原始值(ToPrimitive):先看
[Symbol.toPrimitive];没有的话,转数字时先调valueOf再调toString,转字符串时顺序相反(Date 默认按字符串处理);拿不到原始值就抛TypeError。数组的valueOf返回自身,所以会走到toString,即join(',')。
== 的比较规则:
null == undefined为true,它们和其他任何值比较都是false(null == 0、null == false都是false)。NaN和任何值都不相等,包括自己,判断用Number.isNaN。- 有布尔值参与时,先把布尔值转成数字。
- 数字和字符串比较,字符串转数字。
- 对象和原始值比较,对象先 ToPrimitive。
所以 [] == ![] 是 true:![] 是 false → 转为 0;[] 转原始值是 '' → 转为 0;0 == 0。同理 [] == false、['0'] == false、[null] == 0 都是 true。实际代码里一律用 ===,== null 是唯一常见的例外(同时判断 null 和 undefined)。
经典题:让 a == 1 && a == 2 && a == 3 为 true:
const a = {
  i: 1,
  // == 比较时会调用 valueOf(或 toString / Symbol.toPrimitive),每次返回递增的值
  valueOf() {
    return this.i++
  },
}
console.log(a == 1 && a == 2 && a == 3) // true
B.2 + 0.2 与数字存储
JS 的 Number 统一用 IEEE 754 双精度浮点数(64 位)存储:1 位符号 + 11 位指数 + 52 位尾数。
0.1这类十进制小数转成二进制是无限循环小数,存进 52 位尾数时会被截断舍入,所以0.1 + 0.2 === 0.30000000000000004。比较时用Math.abs(a - b) < Number.EPSILON,金额计算换成整数(分)或者用 decimal.js- 尾数 52 位加上隐含的 1 位,能精确表示的最大整数是
2^53 - 1,即Number.MAX_SAFE_INTEGER(9007199254740991)。后端的 64 位 id 传到前端会丢精度,要用字符串传,或者用BigInt - 位运算会先把数字转成 32 位有符号整数
B.3 var、let、const
- var 有变量提升,声明前访问得到
undefined;let / const 也会提升,但在声明之前处于暂时性死区(TDZ),访问会抛ReferenceError - var 是函数作用域,let / const 是块级作用域(这也是
for循环 +setTimeout那道题的答案) - var 在全局声明会挂到
window上,let / const 不会 - let不允许在相同作用域内重复声明同一个变量,即同一个作用域内不允许出现名称相同的变量。
- const用于声明常量,一旦声明,必须立即赋值,且以后不可更改。
- const命令两个注意点:
- 1.const 声明之后必须马上赋值,否则会报错
- 2.const 简单类型一旦声明就不能再更改,复杂类型(数组、对象等)指针指向的地址不能更改,内部数据可以更改。
- 解释:对象是引用类型,这里的返回值是对象的指针,指向这个对象存储的这个指针,这个指针是不变的,但是,对象本身是可以变的(需要内部也不可变时用
Object.freeze,但它只冻结一层)
B.4 箭头函数和普通函数
- 没有自己的
this,this取定义时外层作用域的this,call/apply/bind也改不了 - 没有
arguments,用剩余参数...args代替 - 没有
prototype,不能当构造函数,new会报错 - 不能用作 Generator 函数(不能
yield) - 没有
super、new.target
所以对象方法、需要动态 this 的事件回调(this 指向元素)、原型方法不适合写成箭头函数;而在回调里想沿用外层 this(比如 class 里的 setTimeout 回调)正适合用箭头函数。
B.5 flex: 1
/* 等价于 */
#app {
  flex-grow: 1;
  flex-shrink: 1;
  flex-basis: 0%;
}
/* 分别代表了所定义flex盒子的拉伸因子、收缩规则、基础宽度。 */
/* 对比:flex: auto = 1 1 auto;flex: none = 0 0 auto;flex: 0 = 0 1 0% */
flex: 1 和 flex: auto 的区别在 basis:前者从 0 开始按比例分配全部空间,所以几个 flex: 1 的子项宽度相等;后者先按内容宽度占位,再分配剩余空间。另一个常见坑:flex 子项默认 min-width: auto,内容过长时不会收缩,要加 min-width: 0 才能让文字省略号生效。
附录 C:开放题
C.1 给你一个项目,从头开始你怎么考虑
可以按这个顺序组织回答:
- 需求和约束:业务类型(ToB 后台 / ToC 营销页 / 内容站)、用户规模和设备、SEO、上线时间、团队技术栈
- 技术选型:渲染方式(SPA / SSR / SSG)、框架和元框架、UI 组件库、状态和请求管理、构建工具,并说清取舍理由
- 工程化:monorepo 还是单仓、TypeScript、lint 和格式化、提交规范、目录约定、环境变量管理
- 质量保障:单元测试、E2E、代码评审、CI 流水线
- 上线和运维:CI/CD、灰度和回滚、CDN 和缓存策略、错误和性能监控
- 长期维护:文档、组件沉淀、依赖升级策略
C.2 工作流做了哪些事情
结合自己项目回答,常见的点:Git 分支规范(主干开发 / Git Flow)、Commitlint + Husky + lint-staged 在提交前检查、ESLint / Prettier(或 Biome)统一代码风格、CI 里跑类型检查和测试、自动构建部署和预览环境、语义化版本和自动生成 changelog、脚手架和代码模板。
C.3 如何提升效率
效率:脚手架和模板、组件库和工具库沉淀、自动化(代码生成、Mock、CI/CD)、更快的工具链(Vite、Rspack、Biome、pnpm)、AI 辅助编码。性能见 页面性能。
C.4 未来的规划是什么
没有标准答案,说清楚技术方向(深耕某个领域还是拓宽广度)以及和应聘岗位的关联即可,参考本文开头 参考 中的「学习 / 成长 / 晋升」。